
koishi-plugin-group-assistant
v2.0.0
Published
群聊治理插件,覆盖入群退群通知、入群审核、刷屏检测、基于关键词与模型的违规内容检测、违规自动处罚,保留审计日志

Maintainers
 ayice666
Readme
koishi-plugin-group-assistant
群聊治理插件,覆盖入群退群通知、入群审核、刷屏检测、基于关键词与模型的违规内容检测、违规自动处罚,保留审计日志。
当前版本:2.0.0
本版本使用 GCRA 重构单人刷屏检测,同时识别瞬时连发和持续高频发送。详细变更见 CHANGELOG.md。
核心能力
- 内容审核:红线词立即处理;敏感词进入语义审核链,可选本地模型服务负责快速分流,需要时再由 DeepSeek 结合上下文复核。
- 刷屏治理:同时覆盖短时间集中刷屏和持续高频发送。
- 分级处罚:按照同类违规次数执行警告、禁言或踢出,并可配置禁言时长。
- 群级规则:不同群聊可以使用独立的红线词库和敏感词库。
- 审计追踪:记录消息处理、AI 复核和违规累计结果,方便管理员复盘治理效果。
- 成员管理:支持入群审核、黑名单和白名单。
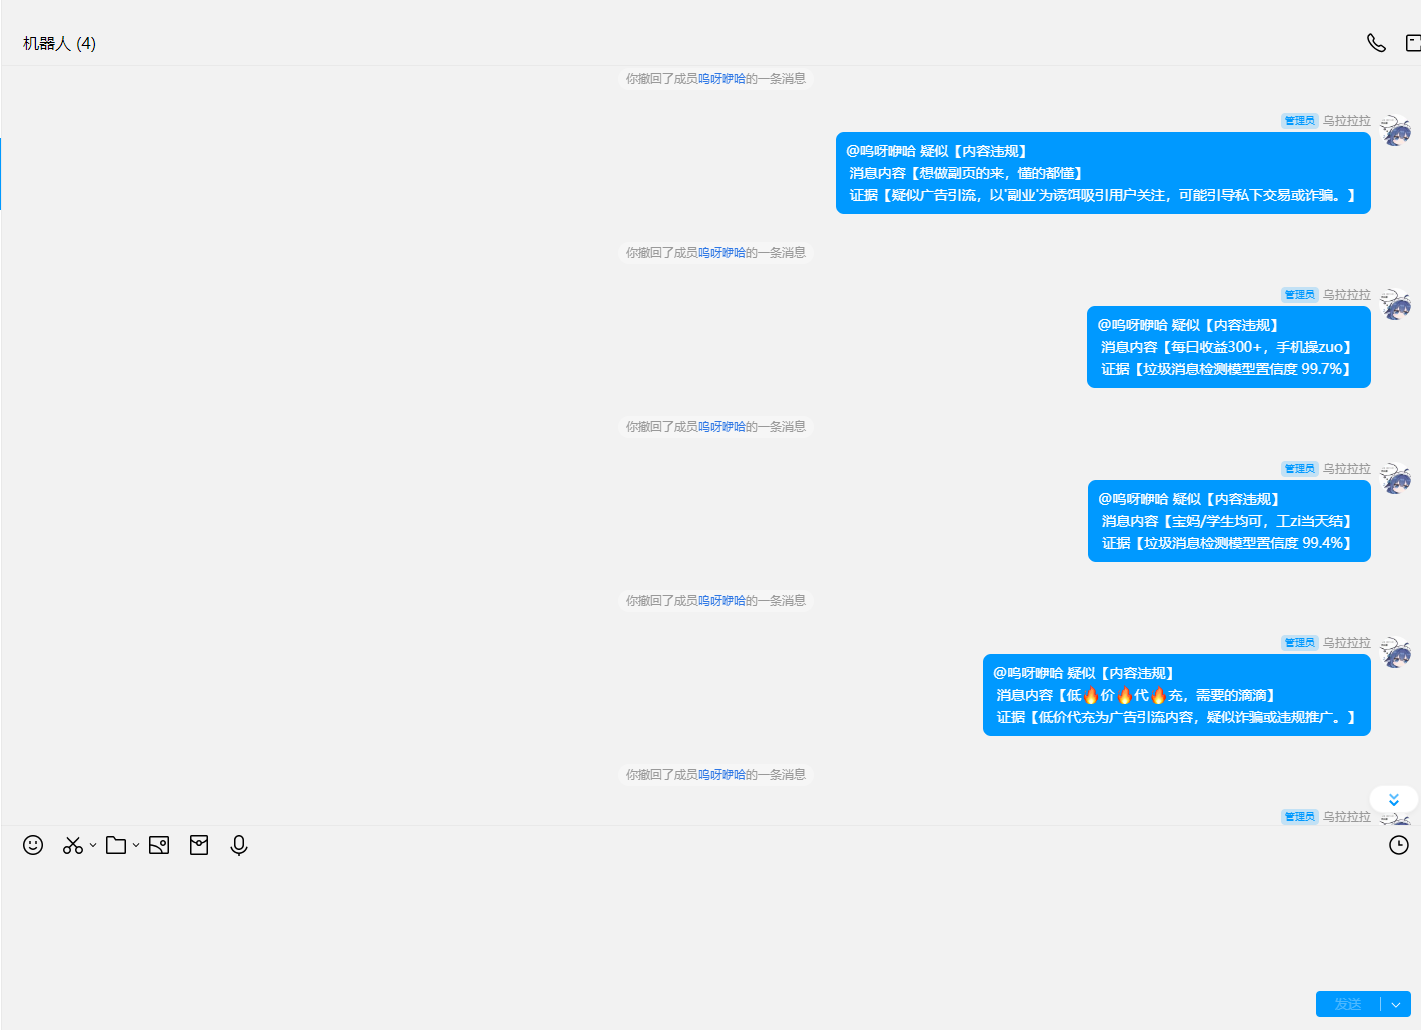
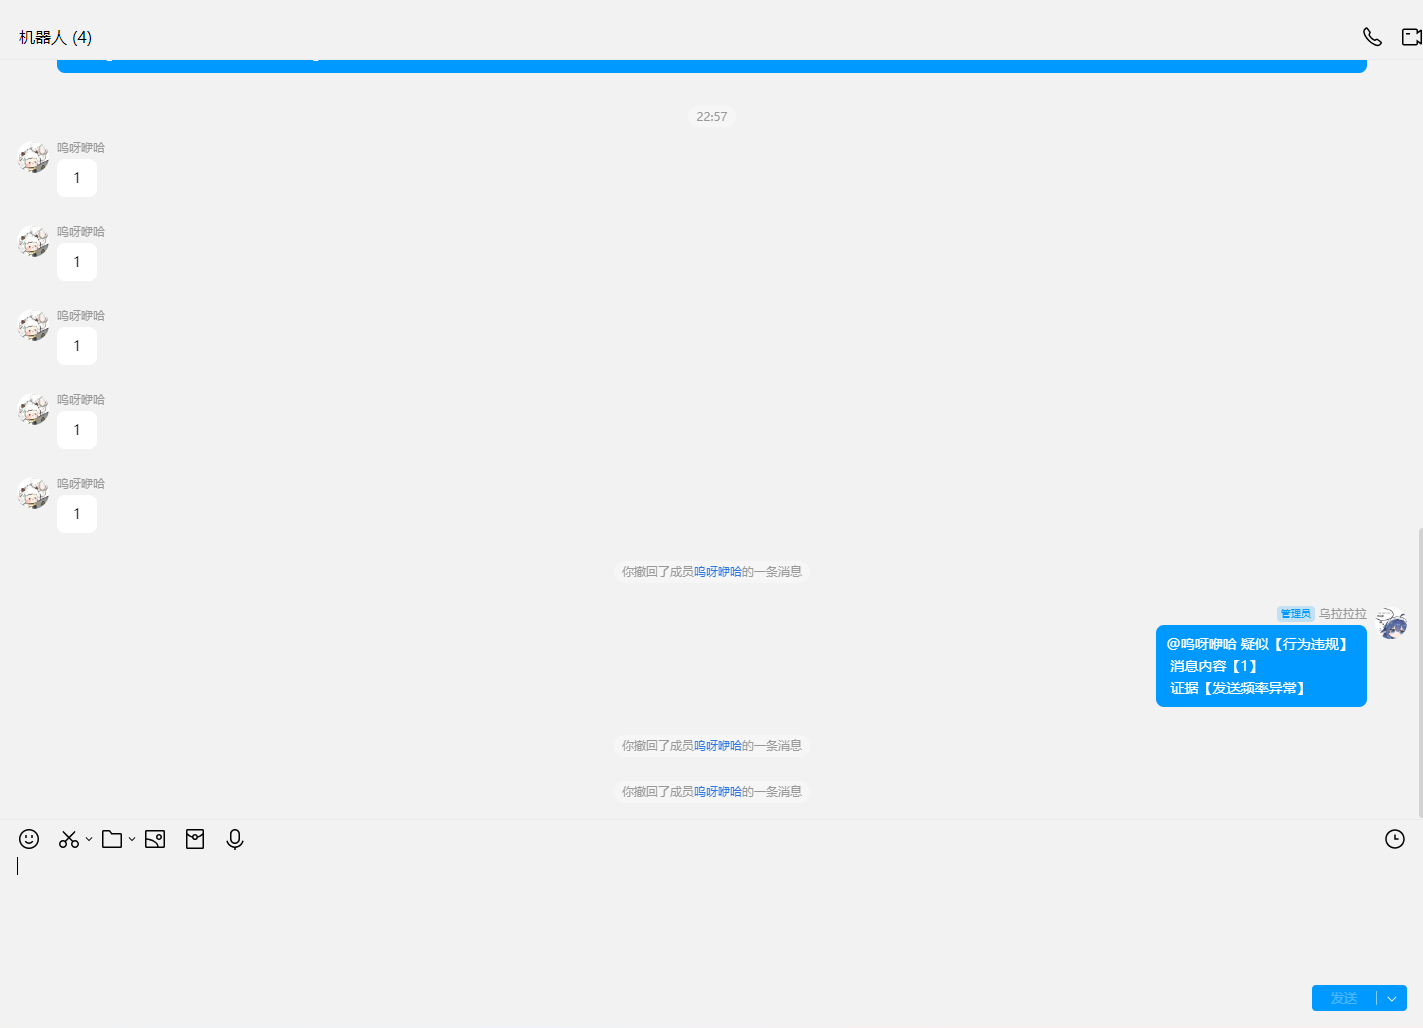
效果演示
安装与使用
安装
在 Koishi 项目中安装:
npm install koishi-plugin-group-assistant然后在 Koishi 配置中启用 group-assistant,并确保数据库服务已经启用。
如需使用本地 BERT 模型,再安装并启用可选配套插件:
npm install koishi-plugin-group-assistant-model-onnx模型文件随 koishi-plugin-group-assistant-model-onnx 一起发布。安装配套插件后会优先自动查找其 npm 包内置的七分类模型;只有需要替换模型时,才需要在 modelPath 中指定自定义目录。
初次使用
- 打开 Koishi Console,进入“群治理”。
- 在左侧添加并选择需要治理的群聊。
- 选择红线词库或敏感词库。
- 添加关键词,或上传 UTF-8 TXT 文件批量导入。
- 在插件配置中选择治理强度和处罚策略。
- 需要使用敏感词 AI 复核时,开启 AI 复核并填写 DeepSeek API Key。
- 需要本地 BERT 检测时,安装并启用
group-assistant-model-onnx,在该插件中配置模型路径、触发策略和阈值。
建议先使用“均衡”治理强度运行,再根据审计记录调整策略。
词库管理
红线词库和敏感词库
| 词库 | 适合放入的内容 | 命中后的处理 | | --- | --- | --- | | 红线词库 | 无需结合语境即可确定违规的关键词 | 立即处理,并累计内容违规 | | 敏感词库 | 可能出现在正常讨论、引用或科普中的关键词 | 进入语义审核;可选本地模型先分流,必要时交由 AI 复核 |
红线词库应保持准确,敏感词库用于覆盖需要结合上下文判断的内容,命中敏感词可选本地模型检测或AI复核。
TXT 导入格式
- 一行一个关键词。
- 使用 UTF-8 编码。
- 空行和以
#开头的行会被忽略。 - 单个文件最大 2 MB。
- 最多 100000 行。
- 单个关键词最多 200 个字符。
导入完成后,页面会显示读取、新增、重复和无效数量。
配置说明
配置页面按用途分为五组,群号范围位于“基础设置”中。
基础设置
| 配置项 | 默认值 | 说明 |
| --- | --- | --- |
| guildIds | 空数组 | 生效群号,仅配置的群聊生效 |
| welcomeMessage | 内置欢迎语 | 新成员入群时发送的内容,支持 {username}、{botName} |
| leaveMessage | 内置退群语 | 成员退群时发送的内容,支持 {userId} |
| botName | 空 | 欢迎语中的机器人名称 |
| signal | 空 | 入群申请暗号 |
| adminUserIds | 空数组 | 白名单用户ID |
群治理设置
| 配置项 | 默认值 | 说明 |
| --- | --- | --- |
| enabled | true | 群治理总开关 |
| governancePreset | balanced | 宽松、均衡、严格或自定义 |
| punishmentLevels | 3 级 | 累计处罚策略 |
| offenseWindowHours | 24 | 自定义模式下的累计违规时间窗口 |
| auditRetentionDays | 30 | 审计记录保留天数 |
内容检测
| 配置项 | 默认值 | 说明 |
| --- | --- | --- |
| contentDetectionEnabled | true | 启用内容检测;红线词立即拦截,敏感词进入AI审核 |
主体插件不包含本地模型配置。若启用 koishi-plugin-group-assistant-model-onnx,以下配置在配套插件中维护:
| 配套插件配置项 | 默认值 | 说明 |
| --- | --- | --- |
| modelPath | 空 | ONNX 模型目录或模型文件路径;留空时优先使用配套子插件内置模型,再查找项目目录中的 external/group-assistant/models/chineseharm-bert-seven/calibrated |
| trigger | sensitive | 仅敏感词命中时检测,或检测所有非立即拦截消息 |
| reviewThreshold | 0.80 | 总违规概率进入 AI 复核的阈值 |
| actionThreshold | 0.98 | 总违规概率直接进入违规处置的阈值 |
行为检测
| 配置项 | 默认值 | 说明 |
| --- | --- | --- |
| behaviorDetectionEnabled | true | 启用刷屏检测 |
| floodRatePerMinute | 15 | 自定义模式下允许单个用户长期保持的发送速度 |
| floodBurstAllowance | 8 | 自定义模式下允许单个用户短时间连续发送的消息数 |
| floodCooldownSeconds | 60 | 自定义模式下持续刷屏重复累计违规的冷却时间 |
AI 复核
| 配置项 | 默认值 | 说明 |
| --- | --- | --- |
| aiReviewEnabled | false | 启用AI内容审核 |
| apiKey | 空 | DeepSeek API Key |
| model | deepseek-v4-flash | deepseek-v4-flash 或 deepseek-v4-pro |
AI 复核用于敏感词候选和本地模型返回 review 的消息。本地模型服务未安装或暂时不可用时,敏感词候选仍可直接进入 AI 复核。
群级配置
guildIds 表示当前插件配置实例针对哪些群生效。留空时不会注册事件、命令、定时任务或中间件;填写群号后,只有列表中的群会使用这套配置。
Koishi 支持通过插件别名创建多套配置。例如:
plugins:
  group-assistant:strict:
    guildIds: ['1047767828']
    moderation:
      governancePreset: strict
  group-assistant:relaxed:
    guildIds: ['123456789']
    moderation:
      governancePreset: relaxed
这样可以让不同群切换到不同配置实例,不需要在配置内部维护多组群配置。治理关闭后,该配置覆盖的群不会执行消息治理、入群审核、欢迎和退群提示;词库和历史记录不会被删除。
处罚模板
每一级处罚的 messageTemplate 留空时,不发送群内提醒,只执行处罚。
支持的变量:
| 变量 | 含义 |
| --- | --- |
| {at} | 被处罚用户的 @ |
| {type} | 违规类型;模型识别到具体类别时为 内容违规:疑似欺诈内容 等,普通广告会追加 请仔细甄别,行为检测为 行为违规 |
| {evidence} | 检测证据;词库命中时包含词库类型、规则编号和原始关键词 |
| {content} | 触发治理的消息内容 |
| {action} | 当前处罚动作 |
| {muteMinutes} | 禁言时长 |
| {offenseCount} | 当前同类违规次数 |
| {level} | 当前处罚级别 |
示例:
{at} 因{type}已被禁言 {muteMinutes} 分钟。
检测证据:{evidence}
消息内容:{content}
当前同类违规 {offenseCount} 次。
管理员指令
以下指令需要群主、群管理员或 adminUserIds 中的管理员执行。
审计和违规状态
违规记录
违规记录 -n 20

违规用户
违规用户 -n 20

违规清零 <userId>违规记录:查看最近的治理记录,最多 30 条。违规用户:查看当前累计窗口内的违规用户。违规清零 <userId>:清除指定用户的累计违规状态,不删除历史审计。
白名单和黑名单
白名单.添加 <userId> [原因]
白名单.删除 <userId>
白名单.列表

黑名单.添加 <userId> [原因]
黑名单.删除 <userId>
黑名单.列表
白名单用户跳过自动群治理。黑名单用户的消息会被撤回,入群申请会被拒绝,并参与违规累计。
手动处置
警告 <userId> [原因]
处罚 <userId> [原因] -a warn
处罚 <userId> [原因] -a delete
处罚 <userId> [原因] -a mute
处罚 <userId> [原因] -a kick
手动处置会写入审计并参与累计处罚。
权限和注意事项
- 群主和群管理员会自动跳过自动处罚。
- 如果适配器无法识别管理员身份,将管理员 ID 填入
adminUserIds。 - 自动撤回、禁言和踢出需要机器人具备对应群权限。
- 词库、审计记录和违规状态依赖 Koishi 数据库。
- 建议先使用均衡预设,再根据实际审计记录调整。
技术原理
整体架构
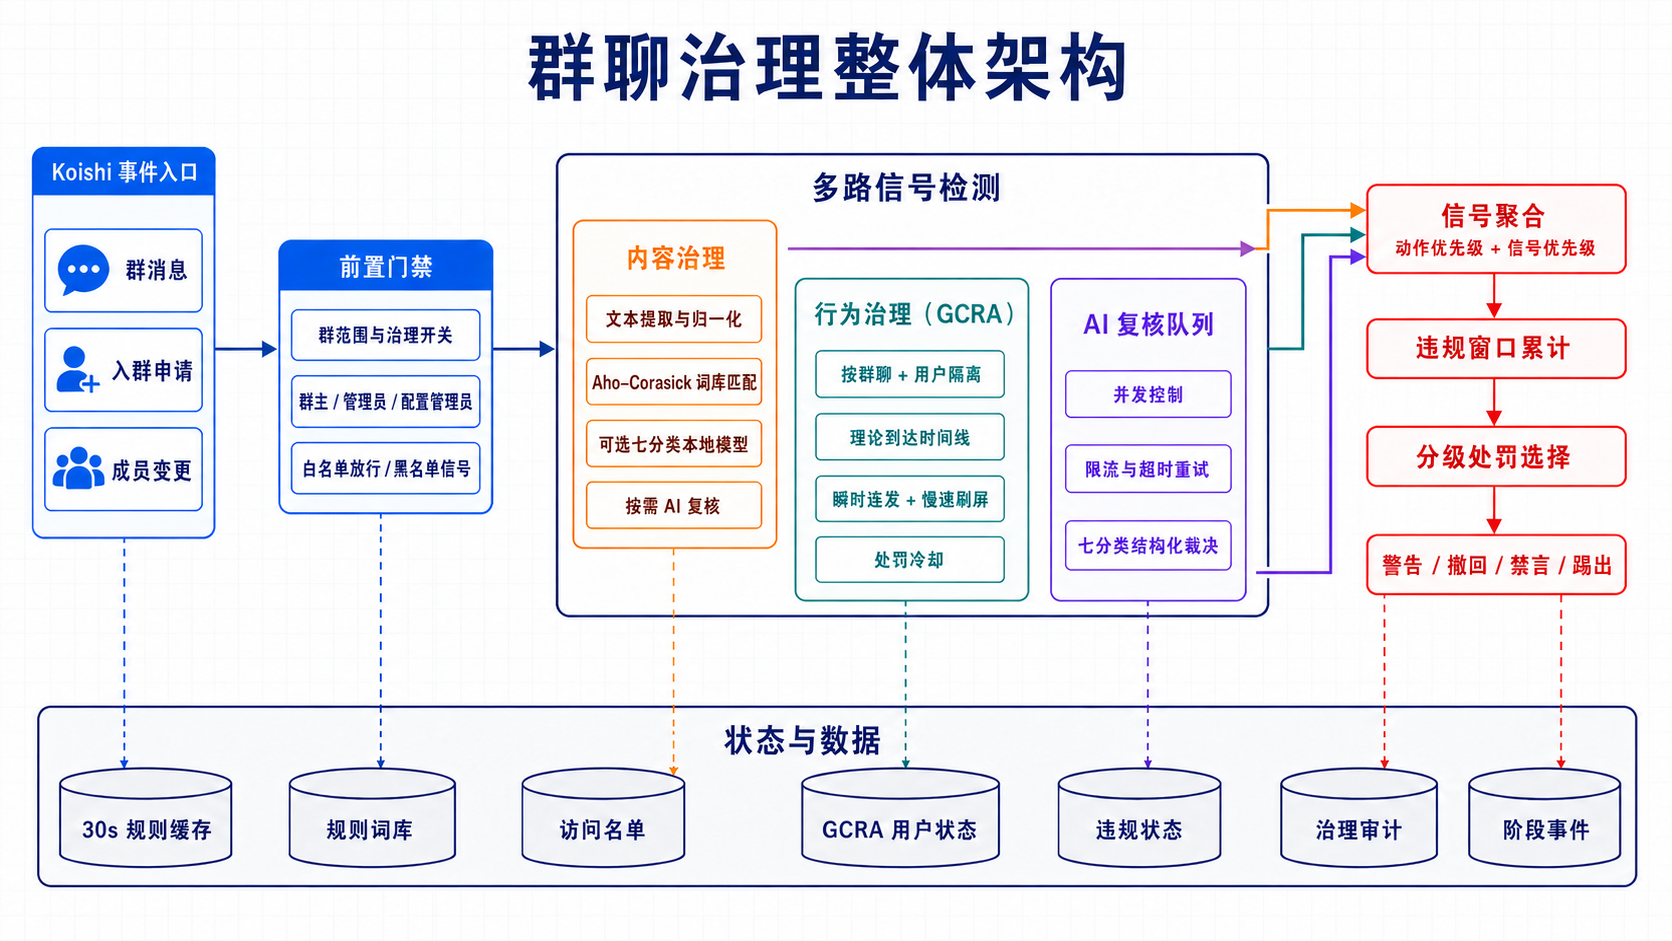
插件在 Koishi 中同时注册事件处理器和消息中间件。成员事件负责入群审核、欢迎与退群提示;群消息进入治理中间件后,先经过范围和权限门禁,再并行产生内容信号、行为信号与名单信号。需要语义判断的内容可以继续调用可选的 groupAssistantModel 服务并进入异步 AI 复核,确定性信号则进入统一裁决链。
| 层次 | 模块 | 主要职责 | | --- | --- | --- | | 事件入口 | Koishi 事件、中间件 | 接收群消息、入群申请和成员变更事件 | | 前置门禁 | 群范围、特权用户、访问名单 | 决定是否进入治理链路,黑名单直接产生高优先级信号 | | 内容治理 | 文本归一化、Aho–Corasick、可选模型服务、AI 复核 | 从规则和语义两个层面判断消息内容 | | 行为治理 | GCRA 单人刷屏检测 | 用同一套虚拟发送时间线识别瞬时爆发和长期持续高频 | | 决策治理 | 信号聚合、违规累计、分级处罚 | 将多个检测结果收敛成一次可执行动作 | | 状态与数据 | 规则、名单、违规状态、审计、阶段事件 | 保存规则和可追踪的完整治理链路 |
主流程可以概括为:
if 消息不在群范围 or 治理关闭:
    放行
if 发送者是群主、管理员或配置管理员:
    放行
if 发送者在白名单:
    放行

views = {
    rawText: 原始 Koishi 消息,
    plainText: 提取文本节点后的正文,
    keywordText: 用于词库匹配的归一化正文
}

signals = []
signals += 黑名单检测
signals += GCRA 单人刷屏检测
signals += Aho–Corasick 词库匹配

if groupAssistantModel 服务存在:
    result = groupAssistantModel.evaluate({ text: plainText, sensitiveMatched })
    result.status == skipped -> 忽略模型结果
    result.status == pass    -> 放行并记录
    result.status == review  -> 异步 AI 复核
    result.status == action  -> 产生确定性内容信号

selected = 按动作强度、信号优先级选择最高优先级确定性信号
if selected:
    更新同类违规窗口
    合并基础动作与累计处罚等级
    写审计并执行警告 / 撤回 / 禁言 / 踢出
else:
    放行;若存在候选信号则等待 AI 异步裁决
1. 治理入口与三种消息视图
消息中间件只处理具有 guildId 且正文非空的群消息。入口依次执行以下短路判断:
guildIds为空时插件不会注册治理功能,否则只处理命中的群。- 群主、群管理员、适配器管理员角色和
adminUserIds中的用户直接放行。 - 白名单用户直接放行。
- 黑名单用户不会立即结束检测,而是产生
blacklist_user信号,后续仍进入统一审计和处罚流程。
每条消息会构造三个视图:
rawText:原始 Koishi 消息字符串,用于审计和 AI 复核。plainText:通过h.parse()解析消息元素,再抽取全部文本节点,避免图片、@ 等结构化元素干扰模型;解析失败时回退到原文。keywordText:对plainText应用词库归一化,用于多模式匹配。
这种分层避免了“为了词库鲁棒性而删除标点”影响语义模型:词库使用强归一化文本,本地模型和 AI 仍使用更接近自然语言的正文。
2. 内容治理算法
2.1 词库导入与文本归一化
词库导入首先限制输入规模:最大 2 MB、100,000 行、单条关键词最长 200 个 Unicode 字符。空行和以 # 开头的注释会被忽略,归一化后相同的词条只保留一份。
消息和关键词使用同一个 normalizeWordlistPattern(),处理顺序如下:
- 使用 Unicode NFKC 将全角字符、兼容字符等折叠到统一形式。
- 删除零宽字符
U+200B~U+200D、U+2060和 BOM,降低插入不可见字符绕过规则的概率。 - 转为小写。
- 将
薇信、带空格的微 信、v x、v 信统一为微信;将扣扣、企鹅号统一为qq。 - 删除全部空白。
- 删除 Unicode 标点和符号。
- 将连续出现三次及以上的同一字符压缩为两次,兼顾“刷字符绕过”和正常叠词。
归一化过程可以表示为:
N(x) = collapseRepeat(
         removePunctuationAndSymbols(
           removeWhitespace(
             mapAliases(
               lower(
                 removeZeroWidth(
                   NFKC(x)
                 )
               )
             )
           )
         )
       )
由于规则和消息共享同一个 N(x),匹配对大小写、全半角、空格、常见标点和少量联系方式变体不敏感。
2.2 Aho–Corasick 多模式匹配
每个群维护一个独立的 AhoCorasickMatcher,用于一次扫描同时匹配该群的全部红线词和敏感词。
构建阶段分为两步:
- Trie 插入:按照归一化关键词逐字符建立前缀树,终止节点保存对应规则。
- 失败指针构建:使用 BFS 遍历 Trie。若当前节点无法沿字符
c继续,就沿fail指针回退,直到找到可转移节点或根节点;同时继承失败节点的输出集合。
匹配阶段只扫描一次正文:
node = root
for char in keywordText:
    while node != root and node 没有 char 子节点:
        node = node.fail
    node = node.children[char] or root
    收集 node.outputs
设所有关键词总长度为 P,正文长度为 N,命中数为 Z:
构建复杂度:O(P)
匹配复杂度:O(N + Z)
空间复杂度:O(P)
命中结果按规则 ID 去重,红线词和敏感词分别有界收集,最终按红线优先返回最多 20 个信号。敏感词达到上限不会停止后续红线扫描,避免消息前部的敏感词掩盖后部红线。
数据库中的启用规则会被编译成按群隔离的自动机,并缓存 30 秒。通过控制台新增、修改、删除或导入规则后会主动清空缓存,因此正常管理操作不需要等待 TTL 到期。
2.3 红线词与敏感词分流
两类词库使用同一匹配算法,但产生不同信号:
| 规则类型 | 初始动作 | 是否需要语义复核 | 用途 |
| --- | --- | --- | --- |
| 红线词 | delete | 否 | 无需上下文即可确定违规的内容 |
| 敏感词 | silent | 是 | 可能存在引用、讨论等正常语境的候选内容 |
红线词和黑名单属于立即信号,会跳过本地模型和 AI 复核。敏感词只是召回候选;是否处置由可选本地模型返回状态和 AI 复核结果共同决定。
3. 可选本地模型服务
本地 BERT 检测由独立的 koishi-plugin-group-assistant-model-onnx 提供。
主体向服务传递的内容只有正文和敏感词命中状态:
groupAssistantModel.evaluate({
  text: plainText,
  sensitiveMatched: sensitiveSignals.length > 0,
})
配套插件完成触发判断、BERT 分词、ONNX 七分类推理和双阈值分流。它返回分类标签、标签置信度、七类概率以及根据配置计算的总违规概率,再根据总违规概率返回标准化状态:
| 状态 | 主体处理方式 |
| --- | --- |
| skipped | 本次不运行模型,继续处理已有关键词和行为信号 |
| pass | 记录模型放行结果,不处罚该内容候选 |
| review | 将模型分类和总违规概率加入证据并进入异步 AI 复核 |
| action | 生成确定性内容信号,进入违规累计和处罚链路 |
红线词和黑名单属于立即信号,主体不会再调用模型或 AI。没有安装配套插件时,敏感词候选直接使用 AI 复核;AI 也未启用时,候选消息不会仅凭敏感词自动处罚。
这种服务边界允许后续接入其他本地分类插件,只要实现相同的 evaluate() 协议,主体治理链路无需了解具体模型格式和推理引擎。
4. AI 复核队列
AI 复核采用异步、限流、可追踪的任务队列。候选消息提交后,主消息流程继续执行;AI 稍后确认违规时,再尝试撤回原消息并执行累计处罚。这种设计避免外部模型延迟阻塞所有群消息。
4.1 队列控制
| 机制 | 实现 |
| --- | --- |
| FIFO | 待处理任务存入数组,由 pump() 顺序取出 |
| 并发限制 | 同时最多执行 2 个任务 |
| 容量限制 | pending + active 最大为 100 |
| 幂等 | 使用 guildId:messageId 作为任务键;缺少消息 ID 时使用用户和时间戳 |
| 去重窗口 | 已见任务键保留 24 小时 |
| 超时 | 每次请求使用 8 秒 Promise 超时包装 |
| 重试 | 模型请求及响应解析最多重试 2 次;违规计次、审计更新和处罚执行不进入重试 |
| 退避 | 两次重试前分别等待 250 ms、500 ms |
队列已满、任务重复、功能未启用或缺少 API Key 时不会静默丢失,而是把 full、duplicate 或 skipped 写入审计状态。
4.2 Prompt 约束与结果校验
系统提示明确把用户消息视为不可信数据,要求模型只做内容审核并只返回 JSON:
{
  "violation": true,
  "category": "不违规|普通广告|黑产广告|谩骂引战|低俗色情|博彩|欺诈",
  "reason": "不超过 80 字"
}
解析器会:
- 从纯文本或 Markdown 代码块中提取最外层 JSON 对象。
- 校验
violation必须是布尔值。 - 校验
category必须属于固定白名单。 - 校验
reason必须是字符串,并截断到 80 字。
不符合约束的响应按请求失败处理并进入重试。最终不违规时将审计更新为 dismissed;确认违规则转成 ai_review 内容信号,进入与确定性信号相同的累计和处罚算法。
5. 行为治理算法
行为检测按 guildId:userId 保存独立状态,通过 GCRA(Generic Cell Rate Algorithm)同时约束短时突发和长期平均发送速度。
5.1 虚拟发送时间线
设长期允许速率为每分钟 R 条、允许连续发送 B 条,则每条消息占用的理论时间和突发容忍时间为:
interval  = 60000 / R
tolerance = (B - 1) * interval
每个用户只保存一个理论到达时间 TAT。新消息到达时间为 now:
earliestAllowedAt = TAT - tolerance

if now < earliestAllowedAt:
    当前消息超限,TAT 保持不变
else:
    当前消息通过,TAT = max(now, TAT) + interval
短时间连续发送会快速把虚拟时间线推向未来,超过突发容忍后立即触发;略高于长期允许速率的发送会逐渐积累虚拟时间差,因此也能识别慢速刷屏。停止发送后真实时间会追上 TAT,状态自动恢复。超限消息不推进 TAT,避免持续发送无限延长恢复时间。
5.2 处罚冷却
每条超限消息都会产生行为信号并进入撤回链路,但只有首次超限或距离上次处罚达到 floodCooldownSeconds 时才累计一次违规并写主审计。这样持续刷屏会被连续拦截,同时避免每条消息都提升处罚等级。
行为证据会同时记录允许速率、突发额度、当前虚拟积压、超出容忍时间以及本次是否新增违规。例如:
个人发送频率超过限制:允许长期 15 条/分钟、短时连续 8 条,
虚拟积压 32.0 秒,超出容忍 4.0 秒,是否新增违规:是
5.3 行为状态的内存边界
行为状态使用 Map 保存,并在每次访问后通过“删除再插入”刷新顺序。策略参数变化时,policyKey 变化会使该用户状态重新初始化,避免旧参数污染新策略。
状态用户数达到 10,000 时会先删除超过 2 小时未活动的条目;若仍超限,则按 Map 插入顺序淘汰最旧条目,限制长期运行时的内存占用。
6. 多信号聚合与确定性裁决
所有检测器都输出统一的 ModerationSignal,其中包含信号类型、来源、证据、基础动作、是否需要 AI、是否累计违规和是否写审计。
同一条消息可能同时命中黑名单、关键词和刷屏。插件先过滤仍需 AI 的候选信号,再对确定性信号排序:
动作优先级:
kick(5) > mute(4) > delete(3) > warn(2) > silent(1)同动作下的信号优先级:
blacklist(9)
  > redline(8)
  > ai_review / spam_model(7)
  > spam_flood(6)
  > others(1)
最终只选择最高优先级信号执行一次主裁决,避免多检测器同时处罚。其他命中仍通过同一个 traceId 写入阶段事件,因此不会丢失解释信息。
如果同步链路已经处置消息,后续 AI 复核只补充内容证据,不再次计次、撤回、禁言、踢出或通知。消息入口按平台、机器人、群和消息 ID 去重,单实例内最多保留 10,000 个 ID、最长 24 小时;容量达到上限时淘汰最早记录。该去重不跨插件重启,缺少消息 ID 时不进行入口去重。
7. 违规窗口与分级处罚
7.1 同类违规累计
违规状态按以下联合维度查询:
(guildId, userId, category)category 目前按信号来源划分为“内容违规、行为违规、名单管控、手动处置”。如果距离最近一次同类违规超过 offenseWindowMs,次数重置为 1;否则在原次数上加 1。每次更新都会刷新 updatedAt,因此这是一个以最近违规时间为基准的滑动累计窗口。
累计和手动清零通过同一 Koishi 根上下文共享的短事务队列执行,覆盖插件别名、同步检测和异步复核的并发更新。旧版若存在同一群、用户、类别的重复记录,下次累计时保留最大有效次数再加一,并在事务内移除重复状态;历史审计保留。无需变更现有表结构,该并发保障针对单个 Koishi 进程,不提供多进程共享数据库的分布式协调。
7.2 处罚等级选择
先筛选所有满足 offenseCount >= level.offenseCount 的等级,再按以下顺序选择最强等级:
- 动作强度:踢出 > 禁言 > 警告。
- 同为禁言时,时长更长者优先。
- 动作和时长相同时,触发次数更高、等级更高者优先。
最终动作取“检测信号基础动作”和“累计处罚动作”中更强的一项:
finalAction = maxByActionRank(signal.action, punishmentLevel.action)例如红线词的基础动作是撤回,即使第一次违规对应的累计等级只是警告,最终仍会撤回消息;累计达到禁言等级后,则升级为“先撤回,再禁言”。
7.3 动作执行
silent:只记录,不做群内动作。warn:按模板发送提醒,不撤回消息。delete:撤回当前消息。mute:先撤回消息,再调用适配器禁言接口。kick:先撤回消息,再调用适配器踢出接口。
撤回、禁言和踢出会检测适配器能力,并在审计阶段事件中分别记录成功、失败或无法执行。撤回失败仍会尝试后续禁言或踢出,通知在动作完成后发送,通知失败不回滚计次、不重试处罚。动作未全部完成时使用结果提示,不套用成功模板;最终动作强于模板对应级别时,改为报告实际动作。提醒模板留空仍保持静默。
8. 审计链路与数据保留
每条进入检测的消息都会生成随机 UUID 作为 traceId。关键词、行为、名单、本地模型、AI 和最终裁决使用同一个 traceId 写入不同阶段:
keyword / behavior / access
        -> spam_model
        -> ai_review
        -> decision
        -> execution_delete / execution_mute / execution_kick
        -> execution_notice
数据分为两层:
group-moderation-audit:保存裁决状态、计划动作、累计次数、消息内容和主要证据;confirmed表示确认违规,不代表动作成功。group-moderation-audit-event:保存每个检测阶段的信号、结果和证据。
阶段事件写入失败不会中断治理主流程。审计正文最多保存 2,000 字,规则模式最多 500 字,证据最多 2,000 字,避免异常输入无限放大存储。
后台任务每 6 小时执行一次清理:
- 超过
auditRetentionDays的主审计和阶段事件被删除。 - 超过违规累计窗口、长时间没有更新的违规状态被删除。
- 规则词库和访问名单不受审计清理影响。
9. 成员事件与访问名单
成员管理与消息治理共用群范围和黑白名单:
- 入群申请先检查群范围和总开关,黑名单用户直接拒绝。
- 配置暗号后,通过正文
includes(signal)判断是否自动同意;未配置暗号时交给其他逻辑或管理员处理。 - 成员加入和退出事件使用模板替换生成欢迎语与退群提示。
- 白名单只跳过自动治理,不删除历史记录。
- 黑名单发言会进入统一信号、累计、处罚和审计链路,而不是在入口直接静默丢弃。
10. 复杂度、边界与调参
| 模块 | 单次消息主要复杂度 | 有界机制 |
| --- | --- | --- |
| Aho–Corasick | O(N + Z) | 每条消息最多 20 个信号,规则缓存 30 秒 |
| GCRA 单人刷屏检测 | O(1) | 每个群用户只保存一份常数状态 |
| 配套插件 tokenizer | 基础扫描为 O(L);WordPiece 最长前缀搜索取决于单词长度,最坏为超线性 | 模型输入截断为 512 token,但预处理仍会扫描完整正文 |
| 配套插件 ONNX 推理 | 由模型结构和序列长度决定 | Session 复用、可只在敏感词命中时触发 |
| AI 复核 | 外部网络调用 | 并发 2、容量 100、8 秒超时、最多 3 次请求 |
| 行为状态 | 平均 O(1) Map 查询 | 最大 10,000 用户,空闲 2 小时后可淘汰 |
L是原始正文长度,N是归一化消息长度,Z是命中数。
治理预设:
| 预设 | 长期允许速率 | 突发条数 | 处罚冷却 | 适合场景 | | --- | --- | --- | --- | --- | | 宽松 | 24 条/分钟 | 12 条 | 90 秒 | 活跃群、通知较多的群 | | 均衡 | 15 条/分钟 | 8 条 | 60 秒 | 大多数普通群 | | 严格 | 12 条/分钟 | 6 条 | 45 秒 | 刷屏较多、需要强治理的群 | | 自定义 | 自行设置 | 自行设置 | 自行设置 | 需要精细调参的群 |
建议:
- 首次启用配套模型插件时,在配套插件中保持较高的直接处置阈值,通过审计观察误判,再逐步调整。
- 红线词优先保证精度;含义宽泛、依赖上下文的词放入敏感词库。
- 正常发言容易触发时提高长期允许速率或突发条数;持续慢速刷屏明显时降低长期允许速率。
- 固定通知机器人或业务账号加入白名单,比整体关闭行为检测更可控。
- AI 复核是异步兜底,不应替代高精度红线规则和本地确定性策略。