
sage-mem
v1.6.0
Published
Cross-session memory for DeepSeek Harness — plain markdown files, no database, no worker.

Maintainers
 gezi-wen
Readme
sage-mem · DSH 的文件式记忆插件 (sage-mem)
English · README.md



给 DeepSeek Harness(DSH)装上跨会话记忆:每条记忆都是本地的一个 Markdown 文件。
File-based cross-session memory for DeepSeek Harness — every memory is a plain markdown file you can open, edit and delete. No database, no worker, no port.
当前版本 1.0.0(稳定版) —— 公开承诺、能力边界与「明确做不到」的清单见 契约冻结。
如果它对你有用,给个 Star 是最直接的反馈。
目录
- 这是什么
- 为什么是文件,不是数据库
- 核心特性
- 快速开始
- 界面预览
- 记忆文件格式
- 检索与注入
- 写入安全
- 自动做梦
- 从 Claude Code 迁移
- 配置参考
- 稳定性与版本策略
- 权限与隐私
- 兼容性
- 架构
- 参与开发
- 常见问题
- 卸载
- 维护者
- 致谢
- 相关项目
- 旧版
- License
这是什么
DSH 原生没有记忆系统。每开一个新会话都是一张白纸:不记得你是谁、不记得昨天做到哪、不记得项目进行到哪一步,于是你每次都要重新交代一遍。
sage-mem 补上这一层,做法是:把该记住的事写成一张张卡片,存在你自己电脑上。在 DSH 把问题交给模型之前,插件按问题挑出最相关的几张、贴在模型眼前。
所以准确的说法不是「模型记得你」,而是「在它开口之前,有人把相关的纸条递进了它手里」。撤走纸条,它又是那个失忆的同事。
记忆的形态是一条记忆一个 .md 文件(YAML frontmatter + 正文):用编辑器就能打开、能改、能删,也能直接拿 git 管。这份记忆始终在你自己手里,不在某个数据库里。
为什么是文件,不是数据库
大多数记忆方案走「SQLite + 常驻 worker」:记忆写进数据库就不透明(想看看存了什么得去查表),事件全捕获又会让库膨胀(「用户打了个招呼」也算一条),还要额外养一个进程和一个端口。
| | 文件式(sage-mem) | 数据库 + worker | |---|---|---| | 看一眼存了什么 | 打开目录 | 查表 / 写脚本 | | 手工改一条 | 编辑器直接改 | 走 API 或 SQL | | 迁移 / 备份 | 拷目录(能跟 git 走) | 导出工具 | | 额外进程与端口 | 无 | 通常有 | | 存不存谁决定 | 由 agent 按规则判断 | 常见做法是无差别全捕获 |
核心特性
| 特性 | 说明 |
|---|---|
| 文件式存储 | 每条记忆一个 .md:frontmatter 存元数据,正文存内容。无数据库、无隐藏格式 |
| 自动注入 | 每轮提问自动扫记忆目录、按相关度挑出最相关的几条注入上下文。模型第一轮就「想起来」,不需要它自己去翻文件 |
| 模型也能自己查 | 另给模型两个检索工具(search_memory / read_memory),它可以主动翻记忆、按行读原文 |
| 写入不被覆盖 | 你正在编辑、模型同时在改的时候,后写的不会静默盖掉先写的;冲突留成待处理记录,由你决定保留哪边 |
| 零额外服务 | 无 worker、无 SQLite、无端口、无常驻进程,不需要额外的 API key 或云服务(运行时唯一的依赖是普通 npm 库 zod) |
| 防膨胀 | 靠规则引导模型判断「值不值得存」:无实质内容的不存,靠读代码 / git 能推出来的不存 |
| 可整理 | 可选的「自动做梦」把记忆通读一遍:合并重复、修索引与断链,改动前先建回滚点 |
| 从 Claude Code 迁移 | 人格(CLAUDE.md → AGENTS.md)照搬;记忆按四类整理成 .md 即可(见下一节) |
界面上还有四块能力(都可以不用):记忆管理页、类型与标签筛选、记忆星图、体检与归档。
记忆管理页的「文件列表」头部还有一个「打开记忆文件夹」按钮:用系统文件管理器打开当前记忆目录 (Windows Explorer / macOS Finder / Linux 文件管理器)。host 侧起一个 detached 进程就返回,不等窗口。
快速开始
需要 DSH 0.1.2-rc.1 或更高(见兼容性)、Node.js >= 18。
# 把 web 换成你自己的 profile 名
dsh plugin --profile web add sage-mem
dsh plugin add 会把包装进这个 profile 并登记它的 bundle —— 不用手改 package.json(手动装法见下)。
装完重启 DSH,确认装上了:
dsh plugin --profile web list然后开一个新会话试三步:
- 跟模型说「记住:我的猫叫芝麻,它喜欢晒太阳」—— 它按规则把这条写进记忆目录
- 再开一个新会话,问「我的猫叫什么」
- 第一轮就该答出「芝麻」—— 记忆由插件自动检索并注入,模型没有主动去翻文件
在 profile 的 package.json 里加依赖,并把包名写进 dsh.profile.bundles:
{
  "dependencies": {
    "sage-mem": "^1.0.0"
  },
  "dsh": {
    "profile": {
      "bundles": ["sage-mem"]
    }
  }
}
本地开发用 clone 出来的源码:
{
  "dependencies": {
    "sage-mem": "link:../sage-mem"
  }
}
改完跑 pnpm install,再重启 DSH。
记忆放在哪
默认在 ~/.sage-mem/memory。想放到别处(比如放进项目仓库、跟着 git 走)就设环境变量:
SAGE_MEM_DIR=/path/to/your/memory状态目录(配置、台账、回滚点、冲突队列)默认在记忆目录的上一层:<记忆目录>/.sage-mem。全部环境变量见配置参考。
界面预览
下面每张图都是从仓库里的界面代码渲染出来的(同一份 CSS、同一棵组件树;数据是演示用的假数据,不是真实记忆目录)。
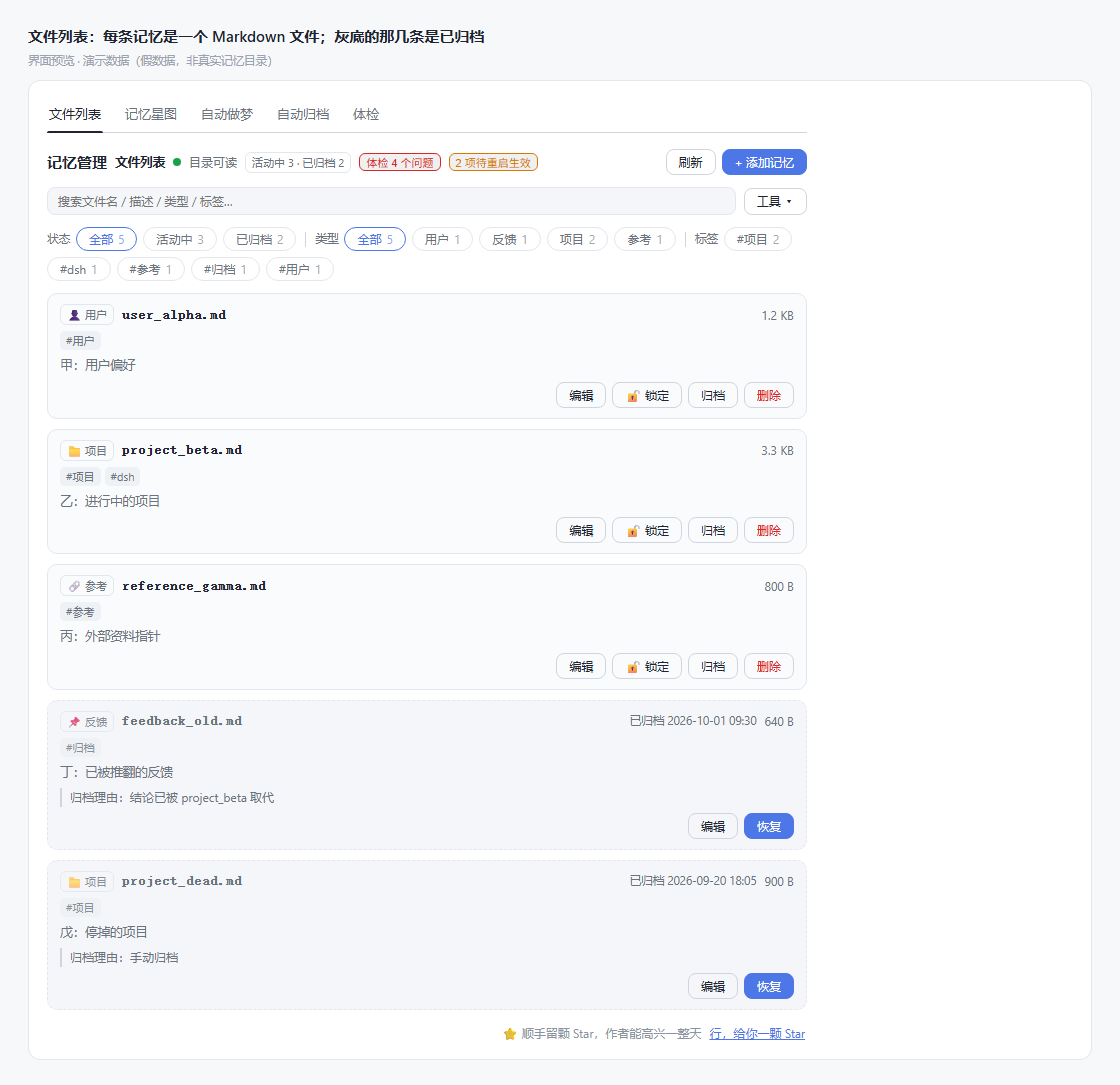
文件列表 —— 头部常显「体检 N 个问题」与「待重启生效」,不用点开就知道该不该处理;灰底条目是已归档,随时可以恢复,也可以点「彻底删除」真的删掉(不可恢复,要再确认一次)。
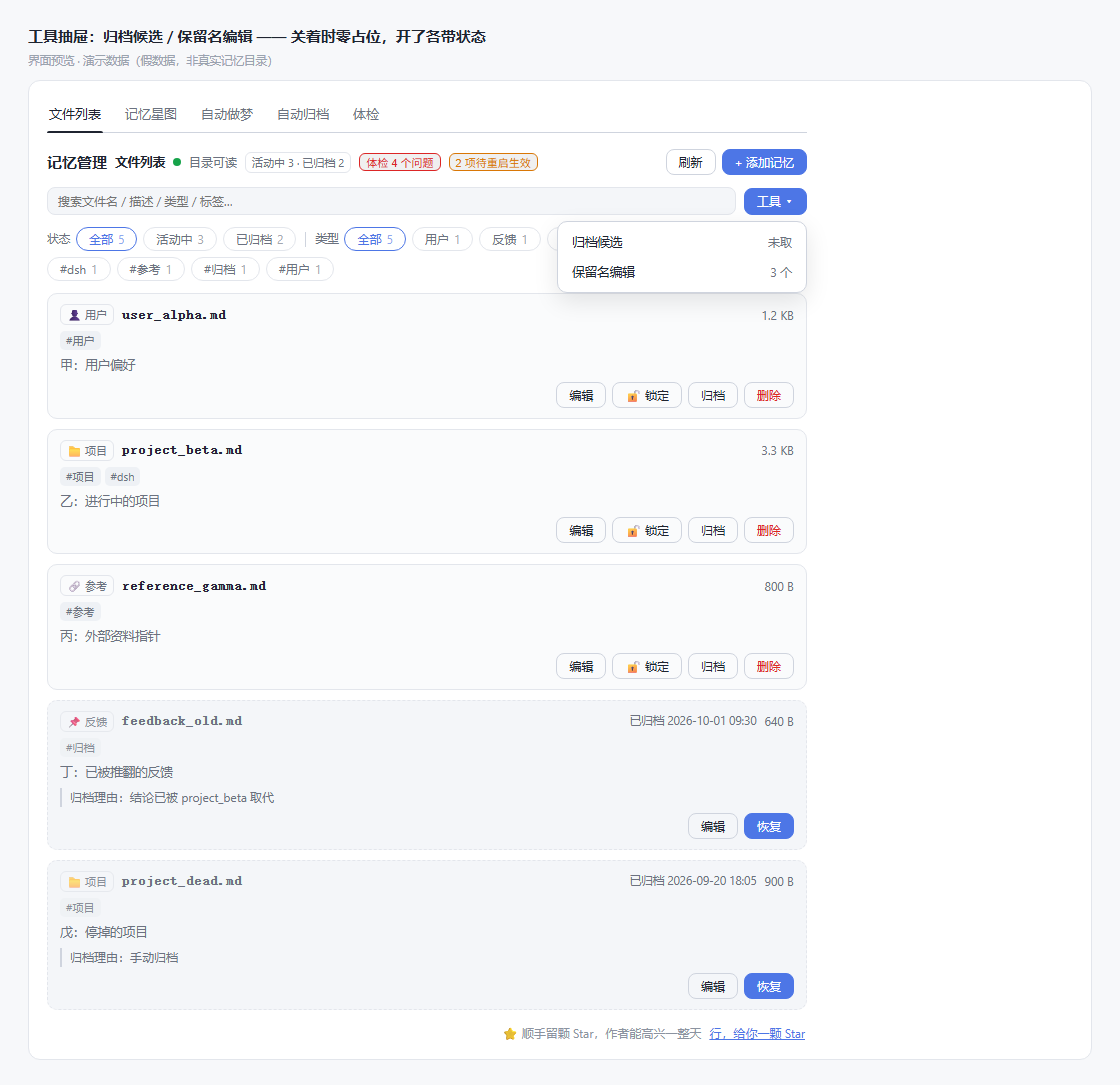
工具抽屉 —— 关着时只占一个按钮,展开后两项各带状态。
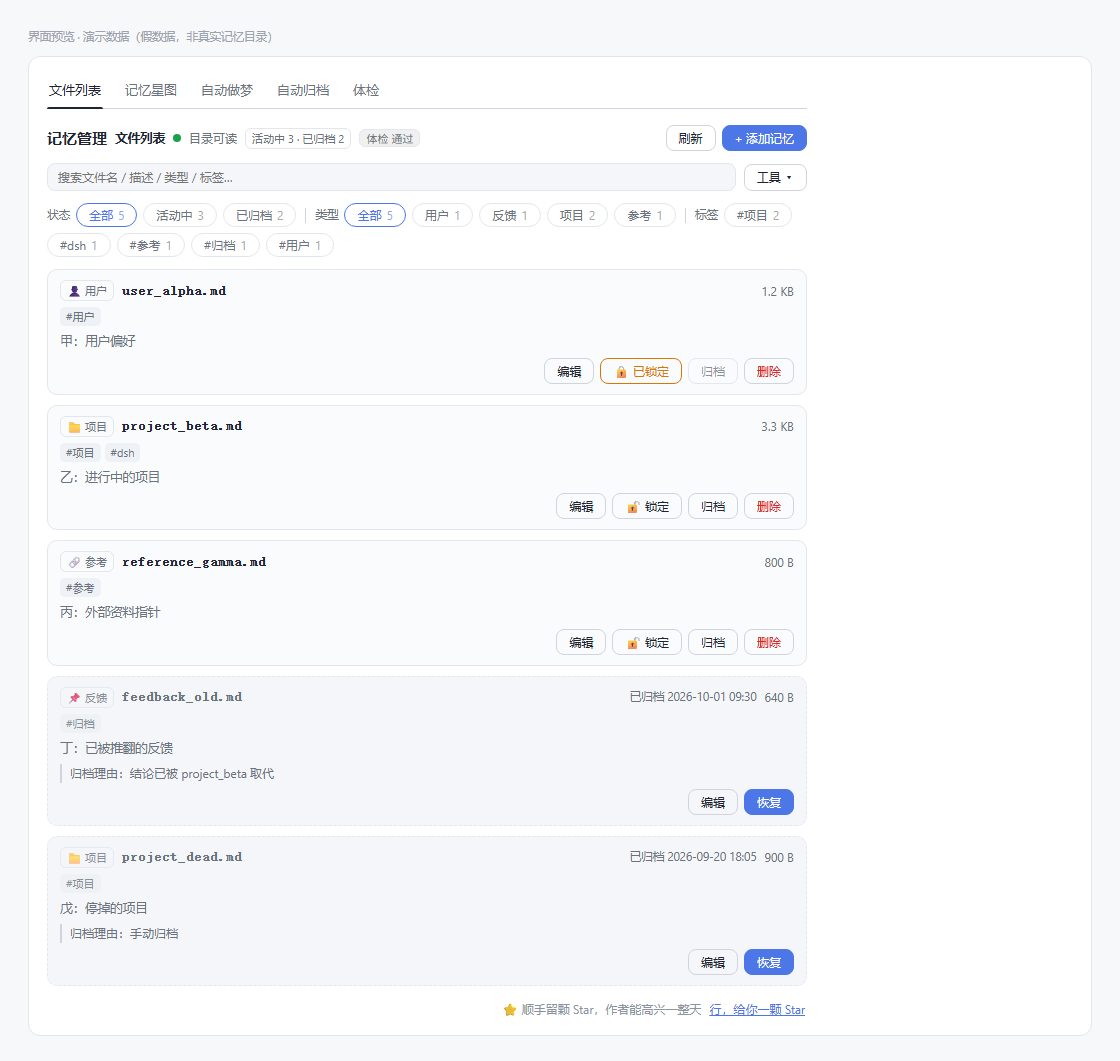
锁定 —— 重要记忆点一下就锁上:自动归档的候选里不再出现它;界面上的归档按钮被禁用,即便绕过界面,归档实现也会以 locked 明确拒绝。锁存在状态目录里、不写进记忆自己的 frontmatter —— 那会被自动整理重写掉,锁一丢它又会回到候选里。
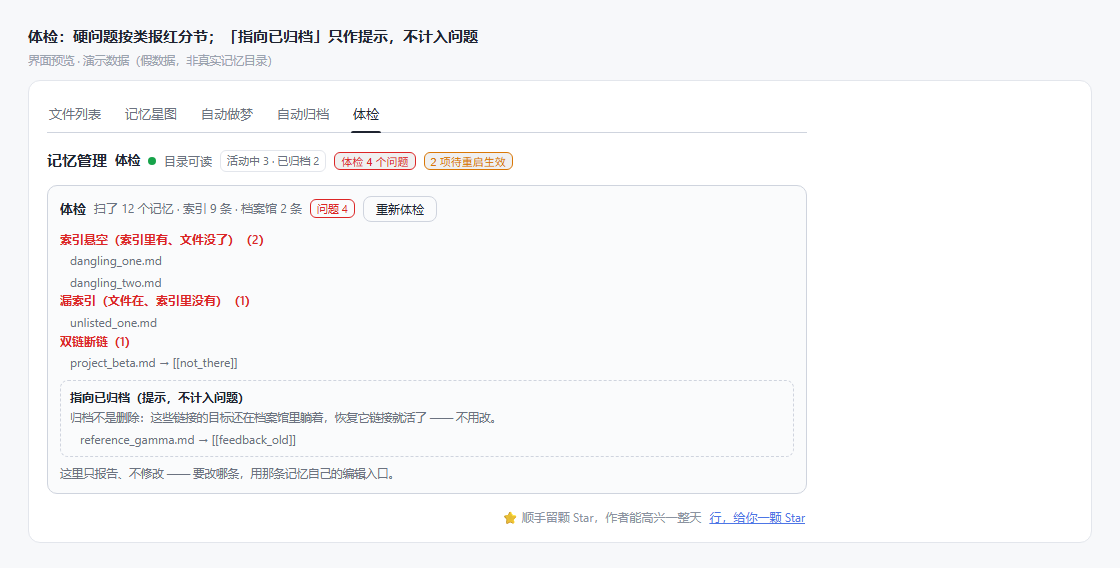
体检 —— 索引悬空、漏索引、断链这类硬问题按类报红;「指向已归档」只作提示、不计入问题,也不提供一键修补(改哪条由你决定)。
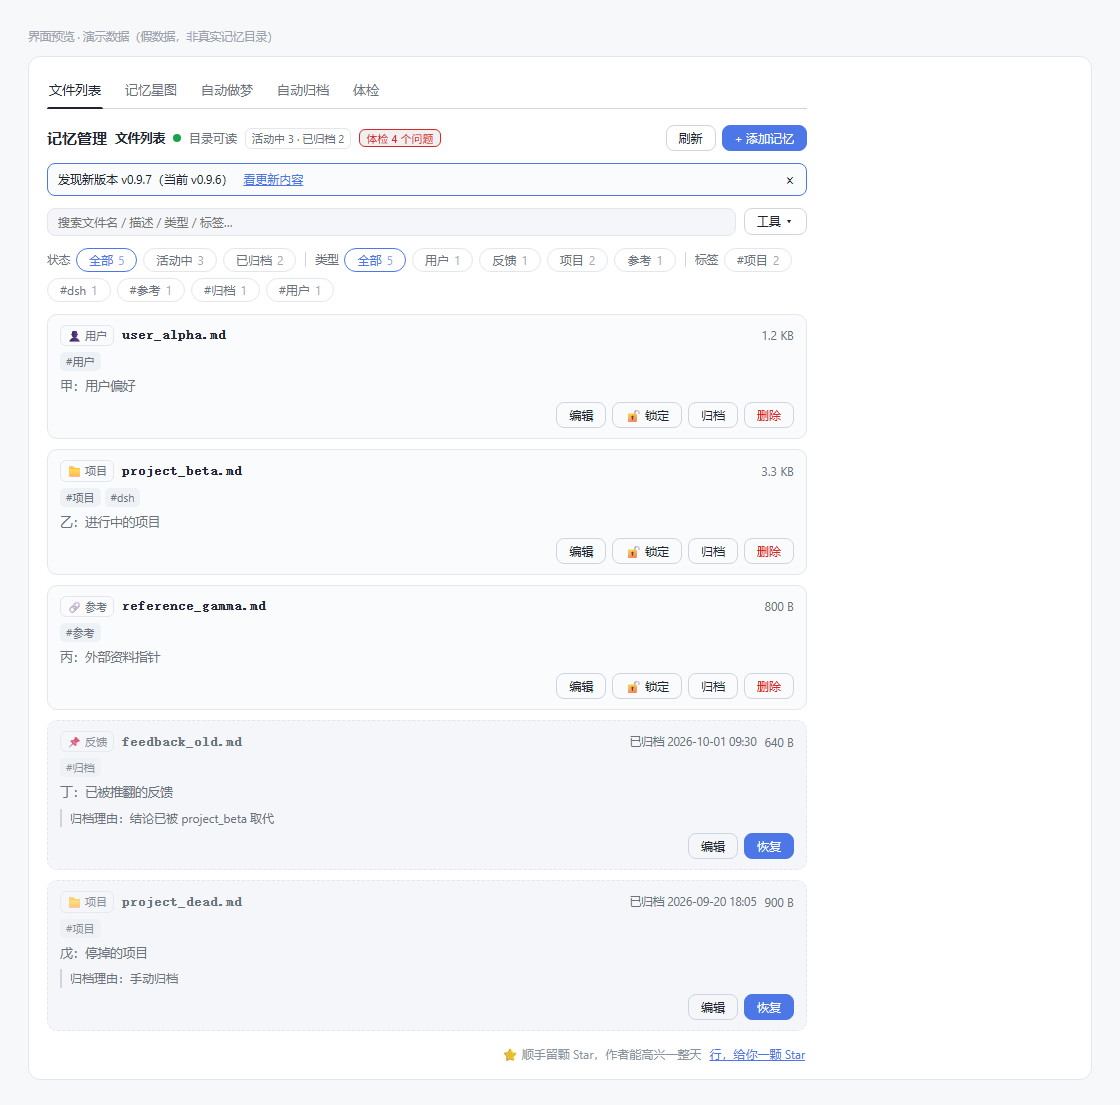
更新提示 —— 只在真有新版本时出现一条横幅,写明新版本与当前版本;「看更新内容」开新标签页,「×」只是这次不看。
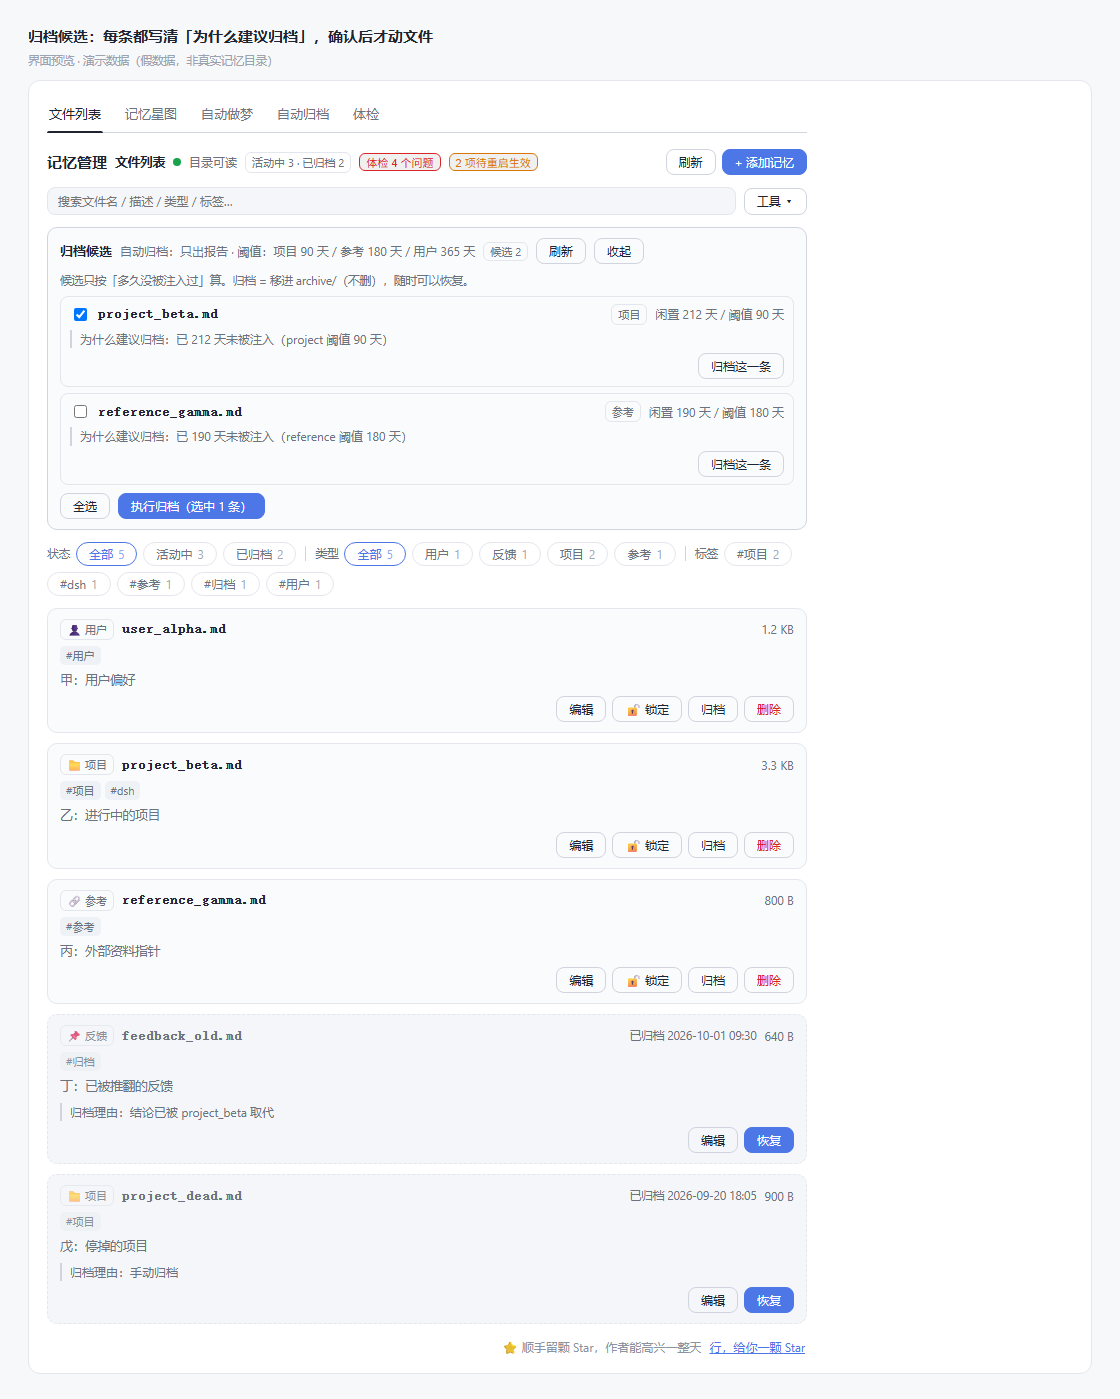
归档候选 —— 每条写清「为什么建议归档」(闲置天数 vs 该类型阈值),逐条或全选后确认才动文件。归档是把文件移进 archive/,不删除;真要删掉一条归档件,得在档案馆里单独点「彻底删除」并再确认一次。
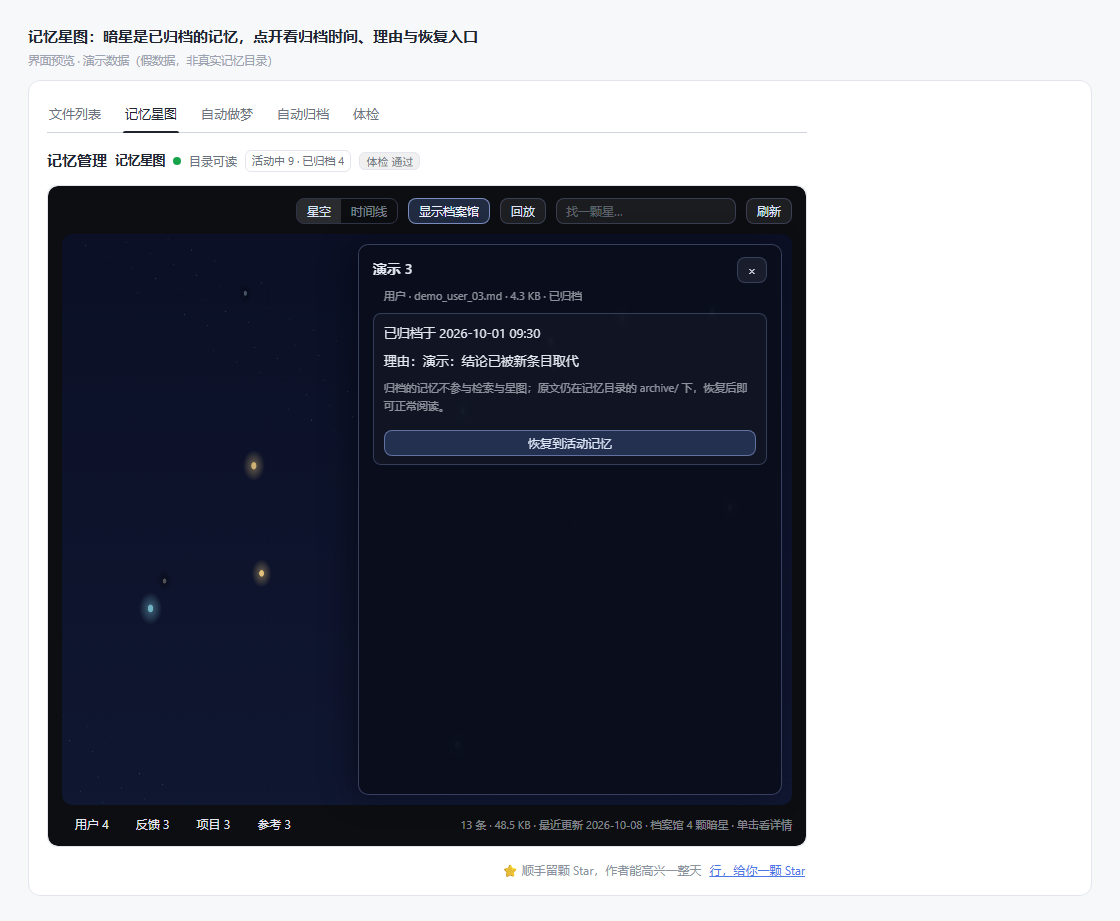
记忆星图 —— 颜色对应类型、大小对应体积、亮度对应新鲜度;暗星是已归档的记忆,点开可看归档时间与理由。
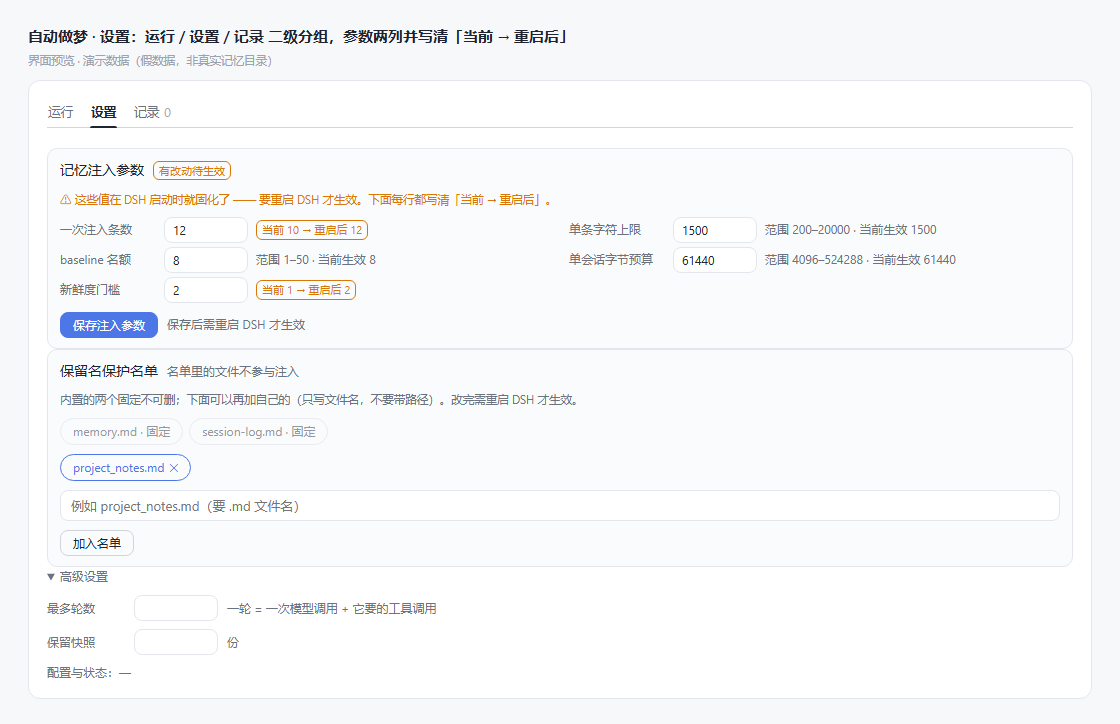
自动做梦 · 设置 —— 运行 / 设置 / 记录 二级分组;五个注入参数两列排开,并写清「当前生效」与「重启后」。
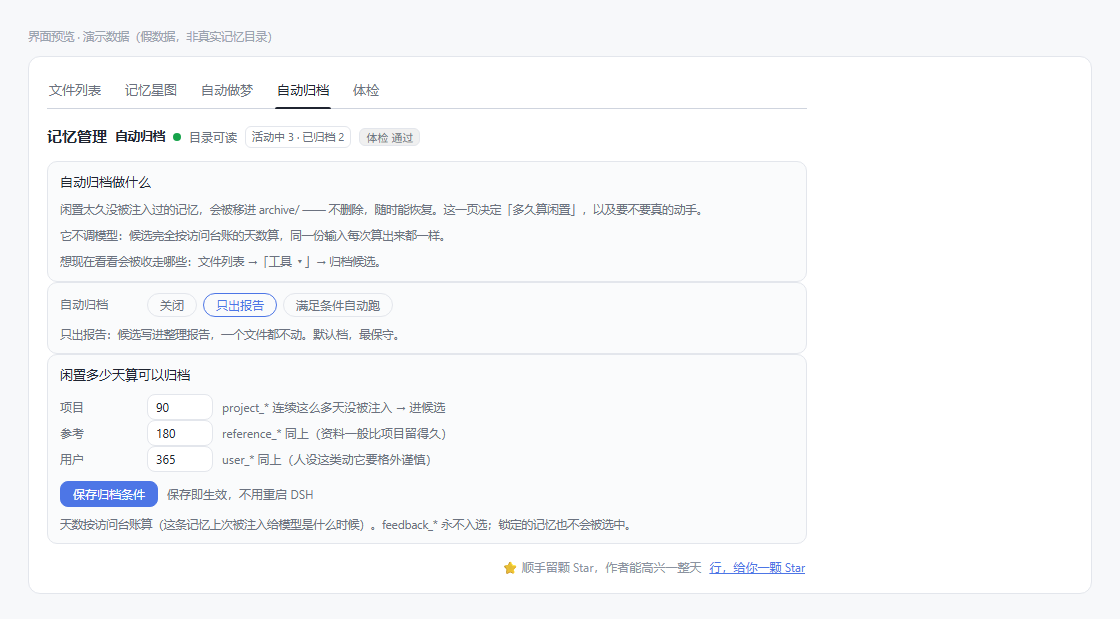
自动归档 —— 它和自动做梦不是一件事:归档是确定性规则(按访问台账的闲置天数算,不调模型),所以单独一页。阈值保存即生效,不用重启。
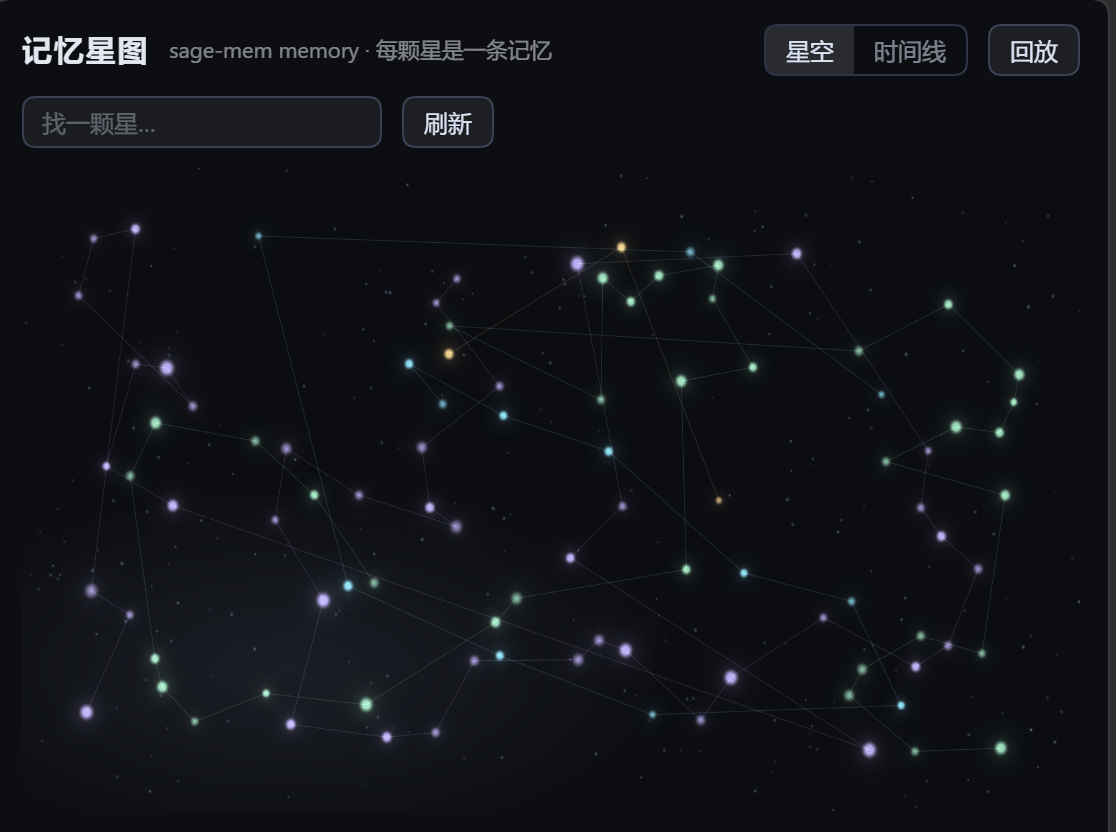
记忆星图全貌 —— 画布上只画关系与分布;悬停或点开某颗星时才显示那一条的文件名。渲染是按需重绘,画面静止时不发起任何绘制。
记忆文件格式
---
name: 可选的短名
description: 一句话说清这条记忆是什么(检索靠它,务必写准)
metadata:
  type: user        # user / feedback / project / reference
tags: [项目, 待办]   # 可选,供列表页筛选(最多 20 个、每个 40 字符)
aliases: [待办, todo] # 可选:换一种说法也能被检索到
baseline: true      # 可选:新会话第一步无条件注入(上限 8 条)
baselinePriority: 10 # 可选:多条 baseline 之间谁先注入(越大越前)
---

记忆正文。
四类记忆:
| 类型 | 存什么 |
|---|---|
| user | 用户是谁 |
| feedback | 工作方式指导(建议带 **Why:** 与 **How to apply:** 两行,方便判断边界) |
| project | 进行中的工作与状态 |
| reference | 外部信息在哪找的指针 |
单文件上限 512 KB,读写两侧都校验(读的时候先看体积,超了就不读进来)。
检索与注入
透明的东西值得说清楚它怎么选料,因为这直接决定注入多少 token。
两段式检索:先摘要,再正文。 第一段用 description + 文件名 + aliases 打分,最多取 10 条候选;第二段对这些候选做正文段落检索(BM25,中文按双字词元),把最相关的那一段注入。比的是段落而不是整份文件,所以一份文件最多贡献一段,长文不会靠段数多霸占候选位。
摘要没写到的,正文能找回来。 摘要是精准的一句话,代价是正文细节天生检索不到;摘要一条都没命中时改由正文检索兜底。正文检索只在问题至少 4 个字符时才跑 —— 继续 这种两个字的问题拿去做正文匹配,命中的全是「继续」这个词本身。
换个说法也能命中: 打分是词面重合,不是语义的 —— 问「我有什么待办」而文件里写的是「代办清单」,差一个字就完全不命中。给这类记忆加一行 aliases: [待办, todo] 就能补上。
注入的是命中段落,不是文件开头。 命中段落标成 ### 项目_部署.md:40-52,模型据此能直接跳到那几行核对来源;段落前补一句该记忆的 description,说明这段是从哪条记忆切出来的。baseline 与没命中正文的文件仍注入开头;单条正文超过字数上限(默认 1500 字符)会截断并标 …(截断)。
相邻的重复问题不会重复注入(按会话只留一个签名),连着问两遍不会又追加一遍。注意这不是「整个会话同题只给一次」:问 A → 问 B → 再问 A,第三次会重新注入 —— 再次要求回忆时重新给证据未必是坏事。
单场会话有预算上限(默认 60 KB),拆成两本账:正文池 = 总上限 − 状态卡预留(5%,夹在 1–4 KB)。到顶之后不是「一个字都不注」,而是正文照旧不注、缺口状态卡照发,告诉你漏了什么、下一步怎么查。压缩或清空上下文之后两本账与卡的签名一起归零,又能注进来。
⚠️ 这个上限是软的,不是硬闸门。
baseline记忆被问句命中时会照注不误、不参与降级,所以单场累计正文可能超出正文池(评测里量到 9.6% 的超支,全部来自这类记忆)。这是有意的取舍:那类记忆的语义就是「每场都该在场」。别把它当成「到 60 KB 就一刀切断」。
缺口状态卡只在真有缺口时说话:有候选没读、或有候选被预算省略时才出现,说清范围、条数、最佳线索和一个可做的动作;一条都没命中时,只有在你问自己的历史、或这条任务有检查点时才说(否则提示会被当噪音忽略)。单张卡上限 512 字节,且按内容签名去重。
摘要侧也有相关性门槛。 中文里「怎么」「什么」这类词元在大量 description 里都有,一句无关的「今天天气怎么样」可能靠一个「怎么」命中十几份记忆。门槛按语料自身的 IDF 尺度归一,无关问题的候选数因此降到约七分之一;被清掉的主要是本就该落选的弱摘要候选。
离线评测集上的对照(门槛前后):Recall@5 84.1% → 87.0%、误注入(注入了与问题无关的记忆)14.1% → 5.6%。
⚠️ 这些是测量,不是承诺:可迁移的是相对改进,绝对水平不可外推到真实记忆目录 —— 那 30 份语料的摘要本来就是照着「能被检索到」手写的,真实记忆的摘要往往写得很随意甚至缺失。方法与局限见评测报告。
意图识别绝不在三类显式请求上抑制重复:「上次决定用 A 对吧」(核实)、「不用 A 了」(更正)、「之前为什么没选 A」(问依据)必须给原文;判不出来就不判,不猜。
模型也能自己翻:两个工具
检索的触发权分两半:一半在插件(自动注入,它猜你想看什么),一半在模型(下面这两个工具,它主动查)。
| 工具 | 用途 |
|---|---|
| search_memory(query, scope?, limit?, cursor?) | 先比摘要、再按段落查正文;返回候选、命中片段、行号,以及覆盖情况(扫了几份、几段因相关性不够被滤掉、有没有下一页) |
| read_memory(name, startLine?, startByte?, maxBytes?, revision?) | 按行分页读正文。带上你上次读到的 revision,内容被人改过时会回 revision_changed,并且不返回内容 —— 否则你会拿着过期行号读错东西 |
两个工具走的是同一条安全读路径(文件名检查 → 符号链接与保留名身份检查 → 体积闸门),没有为工具另开一条绕过闸门的入口。它们通过宿主提供的工具服务注册 —— 不是硬依赖:宿主不提供这个服务时,插件照常工作,只是状态卡换一套「直接读记忆目录」的说法。
长任务的接力棒:任务检查点
宿主什么时候压缩上下文,插件控制不了 —— 所以不承诺「压缩前保存」。能做的是:如果 <状态目录>/tasks/<任务 id>/WORKING.md 存在,注入末尾会给一条短句柄,说清任务、revision 与去哪读。压缩后账本归零会连去重一起清掉,句柄因此重新出现 —— 这就是恢复路径。
任务 id 取 SAGE_MEM_TASK_ID(给跨会话的同一条任务用),否则用会话 id。绝不用你的问题原文去决定读哪个目录。 检查点里「已完成」的条目如果没有任何证据标记(路径、命令、测试结果),解析时会如实报出来 —— 格式完美、内容错误的交接材料仍然是错的。
写入安全
记忆是文件,所以「你正在编辑」和「模型正在改」完全可能同时发生。默认行为是后写的赢、先写的悄悄消失 —— 那是最糟的一种,因为你不会发现。
sage-mem 给记忆目录的写入加了版本守卫:写入前记下当前版本,写入时要求版本没变过。变了就明确拒绝,而不是盖掉 —— 把「静默的坏结果」变成「显式的失败」。
守卫分两条路,覆盖面不一样,说清楚:
| 谁在写 | 怎么保护 | 被拒时 |
|---|---|---|
| 模型用内置 write / edit 改记忆 | 插件在前置事件里给出「当前版本」,宿主据此拒绝过期覆盖 | 宿主直接拒绝(报 FS_STALE_VERSION)。这条路的拒绝不留冲突记录 —— 写门只提供版本,不做拒绝动作 |
| 插件自己写(自动做梦的整理) | 调用方在写入时带上读到的版本 | 落一条待处理记录 <状态目录>/conflicts/<id>.json,里面留着盘上那一版和想要写的那一版 —— 只有一边等于没得判 |
- 冲突不会自动合并,保留哪边由你决定(记录是 JSON,需要时直接打开看)。静默重试和静默放弃都是在替你决定。
- 已知边界:在 shell 里改记忆不走这条路。写门守的是「经过工具的记忆写入」,不是「所有对文件的修改」;
pwsh里的重定向之类认不出来。认不准就不认,免得把「看不到」误记成事实。
访问台账:三种「用过」分开记
<状态目录>/access.json 记三件事:
| 字段 | 含义 |
|---|---|
| injected | 插件被动注入了这份记忆 |
| read | 模型主动读了它 |
| use | 明确被采用的次数(自报) |
分开记是因为这三件事的含义完全不同:被注入只说明插件觉得相关,被主动读只说明模型选了它,都不等于内容有用、更不等于内容正确。混成一个「热度」就再也分不开了。
这张台账目前只用于诊断与自动归档阈值,不参与检索排序。 观测有已知盲区:在 shell 里读记忆认不出来,那就不认。
记忆的新鲜度与引用纪律
每条记忆的标题带新鲜度:(保存于 N 天前),优先读 frontmatter 的 updated:,缺失才回落文件 mtime —— 手写的时间戳是权威,文件系统时间会被复制 / 备份还原 / checkout 整批改掉。
理由是:陈旧记忆被当事实引用时,「引用」这个动作本身会让它显得更权威而不是更可疑。所以注入文本开头还带一节引用纪律(提到路径先确认存在、提到函数先 grep、要动手先核实当前代码),而且它独立成节——它约束的是这一批内容怎么用,压成一条列表项容易和内容混在一起被跳过。
baseline: true 的记忆每场会话第一步无条件注入,最多 8 条 —— 给「你是谁」「待办清单」这类每次开场都该在场的记忆用。⚠️ 「不吃段落替换」不等于整份:它同样受单条字数上限(默认 1500 字符)截断,关键内容若落在尾部会看不到。baseline 适合放短摘要,完整正文留给工具去读。多条 baseline 之间的先后由 baselinePriority 决定(数字越大越前,缺省 0),不按文件名排。
记忆目录读不到、权限错 → 降级为不注入并写日志,不会静默失效。frontmatter 坏掉则宽容处理:解析不出来的字段回落默认(type 缺失按 reference 记),文件本身照样能被读到 —— 不会因为一行写错就让整条记忆消失。
自动做梦
可选的记忆整理功能(标识 autodream):把记忆目录通读一遍 —— 合并重复的、删掉被推翻的、修索引与断链、把相对日期换成绝对日期,让下一次会话能快速对上位置。
默认关闭,在设置页「记忆管理 → 自动做梦」里开。三件事各自可选:
| 选项 | 取值 | 说明 | |---|---|---| | 触发 | 只手动 / 满足条件自动跑 | 自动模式走三级门控,最便宜的先查:时间门(距上次 ≥ N 小时,一次读写)→ 会话门(期间 ≥ M 个会话有更新,一次目录扫描)→ 锁(防并发)。中间夹一层 10 分钟扫描节流,免得「时间门过了、会话门没过」时每轮白扫 | | 改动方式 | 只出报告 / 直接改写 | 「只出报告」模式下写工具根本不会挂给模型 —— 不是靠一句「请不要写」约束,是它没有手 | | 输入源 | 仅记忆目录 / 记忆 + 会话记录 | 后者会解压会话记录(zstd)做定向关键词搜索;代价是私密对话会进入模型上下文,token 成本也更高 |
自动触发走插件自己的定时器(默认 30 分钟查一次门控)。整理刻意不走会话 —— 工具集由插件给、步数有上限、不写进你的会话记录。
整理用的模型可以单独指定
整理是后台批量任务,跟聊天用的不一定是同一个模型。设置页「高级设置 → 模型」可以从当前已配置的模型路线里挑一条(选项与「模型选择」里的目录同源)。
- 选了就只认它:路线在宿主里不存在时开工前就报错(只比对宿主已注册的目录、不发任何请求),不会跑到一半才失败,也不会静默回落到默认模型。
- 面板下方始终显示实际生效的是哪条;配置里那条路线万一从目录里消失了,下拉框也会把它显示出来而不是悄悄跳回默认。
- 拿不到模型目录时(宿主差异),退化成手填
provider与model。
回滚点
只要这次是「直接改写」,开工前就先建一个回滚点(记忆目录顶层 .md 全量快照,每条带 sha256),跑完之后能在设置页看到它、也能一键退回去。
- 回滚点与这次运行绑定:报告里写着 runId,回滚点目录同名,两边对得上。
- 回滚本身也能退:动手之前会先把「现在」再存一份保护快照(不参与普通快照的轮转淘汰)。
- 范围可选:只恢复这次运行动过的文件,或整目录回到该时点。
- 全程不删文件:回滚中「不该存在」的文件一律移进
archive/,人工可捞回;有同名冲突就跳过并计数,绝不覆盖。 - 每次回滚都留痕:报告目录里写一份回滚报告,并在状态目录里追加一条记录。
整理声明:改了什么、为什么
每一次整理都留下一份声明,两种形态:人读的 memory/autodream/<runId>.md(报告里内嵌)、机读的 .sage-mem/autodream/runs/<runId>/manifest.json。
逐条记录:文件 / 操作(新建·改写·归档)/ 缘由 / 字节变化,外加运行前后的结构审计对比。
reason应当填写。write_memory不带reason不会被拒绝 —— 改动照样生效,但声明里会把它标成「未自述」并附上宿主能追溯到的信息(第几轮 / 什么操作 / 字节变化)。理由:为了一句解释而丢掉一次本来正确的修正,代价更大。archive_memory的reason仍必填,缺了直接拒绝;被拒的动作单列一节「未能落地的改动」,不会静默消失。
三道安全网
- 安全边界在工具集上,不在提示词里 —— 自动做梦时宿主只把只读工具交给模型,改写模式才多给改写工具;而且没有「删除」这个能力,归档是把文件移进
archive/,可以人工捞回。 - 改写前自动建回滚点,落在
<记忆目录的上一层>/.sage-mem/autodream/snapshots/<runId>/,保留最近 N 份。理由是记忆目录不在任何版本控制下、删除没有回收站,「可回滚」得自己造。 - 跑完自动审计 —— 索引悬空、漏索引、
type与文件名前缀不一致、CRLF、双链断链、frontmatter 里被 YAML 当注释吞掉的「空格 + #」、无 frontmatter、归档中途残留的临时文件,外加「读不动」单列一类,结果与前后对比写进报告。它只报不改。
改名说明
本功能原名「做梦」(标识 dream),0.7.0 起叫 自动做梦(autodream)。旧数据不会被丢:老的配置 .sage-mem/dream.json 会被读出来并迁移到 .sage-mem/autodream.json(旧文件保留不动),老报告 memory/dream/ 仍在面板里列出并标「旧版」,老快照也仍可回滚。
从 Claude Code 迁移
如果你已经在 Claude Code(CC)里养了一个 agent,sage-mem 是「CC → DSH」迁移方案的一部分。我们自己的记忆就是这么迁过来的 —— 当时两边的记忆都已经是 Markdown 文件,直接拷过来就能用。
两样东西的搬法不一样,说清楚:
| 搬什么 | 从 | 到 | 怎么搬 |
|---|---|---|---|
| 人格 | CC 的 CLAUDE.md | DSH 的 AGENTS.md | 都是纯文本、DSH 原生加载,内容照搬即可 |
| 记忆 | CC 里沉淀的跨会话语料 | sage-mem 的 memory/ 目录 | 一条记忆一个 .md,带 frontmatter,按 user / feedback / project / reference 四类归位 |
⚠️ 前提是形状对得上。 四类划分与 frontmatter 是 sage-mem 自己的约定:如果你在 CC 里的记忆本来就是「一条一个 Markdown + frontmatter」(我们当时是这种),拷过来即可;如果不是(比如都堆在一个 CLAUDE.md 里),需要先整理一遍 —— 这活儿正好可以交给一个 agent 做:让它读旧语料,按四类落成文件。
配置参考
环境变量
| 变量 | 默认 | 说明 |
|---|---|---|
| SAGE_MEM_DIR | ~/.sage-mem/memory | 记忆目录 |
| SAGE_MEM_STATE_DIR | <记忆目录的上一层>/.sage-mem | 状态目录(配置、台账、锁、冲突队列、回滚点) |
| SAGE_MEM_MAX_SESSION_BYTES | 61440(60 KiB,4096–524288) | 单场会话注入总量上限 |
| SAGE_MEM_MAX_RESULTS | 10(1–30) | 每轮注入的候选条数上限 |
| SAGE_MEM_MAX_CHARS | 1500(200–20000) | 单条记忆注入的字符上限 |
| SAGE_MEM_MAX_BASELINE | 8(1–50) | baseline 名额 |
| SAGE_MEM_STALE_DAYS | 1(0–365) | 标题标「保存于 N 天前」的门槛;0 = 每条都标 |
| SAGE_MEM_TASK_ID | 空 | 任务检查点的作用域;空则回落会话 id |
| SAGE_MEM_DEBUG | 关 | 调试日志 |
取值语义:越界夹到边界,非法值(含纯空格)回落默认。
设置页里能改的
面板可改上面五个上限(写入 <状态目录>/settings.json,优先级 设置页 > 环境变量 > 内置默认),以及保留名(受保护、设置页不许写删的文件名,写入 <状态目录>/reserved.json)。部分项要重启 DSH 才生效,面板上会写清「当前生效 / 重启后」。
状态目录里的文件
| 文件 | 用途 |
|---|---|
| access.json | 访问台账(injected / read / use) |
| conflicts/<id>.json | 待人工处理的写入冲突 |
| tasks/<任务 id>/WORKING.md | 任务检查点 |
| settings.json / reserved.json / locked.json | 设置、保留名、锁定 |
| autodream.json、autodream/ | 自动做梦的配置、快照、运行记录 |
| dream.json | 旧版名字,只在迁移时读一次 |
除 access.json、conflicts/、tasks/ 之外,其余是实现内部状态,格式可能在小版本里变,别依赖。
稳定性与版本策略
1.0.0 是这个项目的稳定线。 从这一版起,「你可以依赖什么」不再是一段自我评价,而是可被机器推翻的清单:
- 契约冻结 —— 公开面逐条写清定性,只有四种措辞:保证(有断言支撑,回归会红)/ 尽力(设计如此、有实测依据,但没有会红的回归断言)/ 明确做不到(能力边界,是取舍不是缺陷)/ 未验证(我们不知道)。
- 每条「保证」都指得出一条具体断言(某个测试套件里的一项),并在每次
npm test里由test/contract-binding-test.mjs核对「这条断言真的跑过」。指不出断言的承诺,只能标「尽力」或「未验证」。 - 能力边界表 与契约逐行交叉引用,由
test/doc-consistency-test.mjs核对两边定性相同。
版本号怎么涨(语义化版本):
| 改动 | 版本 | |---|---| | 改契约里标「保证」的任何一条、改工具名或必填参数、去掉老格式台账的读兼容、改注入段名 | 大版本 | | 改措辞、改排序细节、改内部状态文件格式、改面板、加新的环境变量、改性能 | 小版本 / 补丁 |
从 0.9.x 升到 1.0.0:没有破坏性变更 —— 工具名、参数、环境变量名与默认值、注入段名、台账格式一个都没改。唯一的行为变更是:整数型环境变量填纯空格时,现在回落默认值(此前会被当成 0 而夹到下限)。逐条清单见 CHANGELOG 的 1.0.0 一节。
审查材料(给愿意深挖的人):
| 文件 | 内容 | |---|---| | 1.0.0-contract.md | 公开承诺逐条定性 + 每条保证指向的断言 | | 1.0.0-boundaries.md | 35 条能力逐条定性(含依据与验证手段) | | 1.0.0-eval-report.md | 检索质量与预算的量化结果,以及这些数字测不到什么 | | review-findings.md | 外部复审发现的永久账:每条发现、处置、由哪条断言看着 | | release-checklist.md | 发版纪律(脱敏四查、评测退出码、探针、四锚点) |
权限与隐私
sage-mem 只做三件事,全都在你本机:
| 它做什么 | 具体范围 |
|---|---|
| 读记忆 | 只读 SAGE_MEM_DIR(默认 ~/.sage-mem/memory)下的顶层 *.md,单文件上限 512 KB |
| 写记忆 | 经模型的文件工具或设置页写同一个目录;MEMORY.md、session-log.md 等保留名受保护,设置页碰不到 |
| 注入 | 把选中的记忆作为上下文交给模型(最多 10 条相关 + 8 条 baseline,单场会话累计 60 KB —— ⚠️ 这个上限是软的,见检索与注入) |
它不做什么:不开端口、不起常驻进程、不需要任何 API key;不做事件全捕获(存不存由模型按规则判断,不是「你说了什么都记」)。
两处出网 / 越界读,说清楚:
- 版本检查:打开「记忆管理」页时会静默请求一次
https://api.github.com/repos/gezi-wen/sage-mem/releases/latest(10 秒超时,失败一律不提示)。 请求里只有插件自己的User-Agent;不含任何记忆内容、文件路径或使用统计。环境里有GITHUB_TOKEN/GH_TOKEN时会带上它(把 GitHub 未认证的 60 次/小时提到 5000)。这是唯一的出网请求。 - 会话记录:「自动做梦」的输入源选「记忆 + 会话记录」时,它会额外读
$DSH_HOME/sessions下的会话记录做定向搜索 —— 那会解压你的对话原文(含私密内容)并送进模型上下文。默认关闭。
唯一会调用模型的功能是「自动做梦」,默认关闭。 它的模型默认跟随当前会话默认模型,也可以在设置页单独指定一条 —— 指定了就只认它,不会静默回落。
记忆就是那个目录里的文件,随时可以打开确认 —— 这也是选文件式的原因。
兼容性
sage-mem 是纯 DSH 插件,用 package.json 的 engines.dsh 声明宿主要求:>=0.1.2-rc.1 —— 单边开区间、不设上界,所以任何未来的 DSH 版本都不会被这道声明挡住。engines.node 要求 >= 18。
逐版本核对记录:
| DSH 版本 | 状态 | | --- | --- | | 0.1.2-rc.1 | compatible | | 0.1.3-alpha.1 | compatible | | 0.1.3-alpha.2 | compatible | | 0.1.5-rc.1 | compatible | | 0.1.6-alpha.1 | compatible | | 0.1.6-alpha.2 | compatible | | 0.1.7-rc.1 | compatible | | 0.1.7-rc.2 | compatible | | 0.2.0-rc.1 | compatible | | 0.2.0-rc.2 | compatible |
两点值得说明:
- 同一份构建同时覆盖
0.1.x与0.2.x两条线。 自 DSH0.1.6-alpha.2起 TypertCodec 契约从「读schema」改为「读create()工厂」,仍只写schema:的插件会在注册阶段直接抛错、把整棵插件树拖垮。本插件的每个 codec 同时带schema与create: () => schema,两个时代的 DSH 都能加载。peer 依赖@deepseek-ai/dsh-typert-protocol与@deepseek-ai/dsh-client-locale的范围去掉上界,避免以后某个大版本被这道声明误挡(这两个包在0.1.7-rc.2与0.2.0-rc.1之间导出符号零增删,逐字节比对过)。 - 带一层防御留痕。 注入链依赖的事件名与字段在日常升级中很稳定;如果哪天 DSH 把它们改成异步或改了名,插件会在日志里报警,而不是静默地不再注入记忆。
架构
DSH(Cordis 插件宿主)
  └─ sage-mem 插件(按问题检索 + 注入)← 本仓库
       │  Node fs 直读 / 直写
       ▼
memory/ 目录(markdown 文件,4 类)
  ├── user_*.md
  ├── feedback_*.md
  ├── project_*.md
  ├── reference_*.md
  └── MEMORY.md          ← 索引
没有 worker、没有 SQLite、没有 HTTP 端口、没有常驻进程。
模块边界(1.2.0 起):
lib/index.js—— 组合根 + 三个 Gateway。typert manifest 的sourceLocation钉在这个文件上,所以 Gateway 类不搬走(搬 = 契约漂移)lib/recall/—— 注入链:选材(select)/ 渲染与预算(compose)/ 文本(text)/ 会话状态(state)lib/assembly/—— 四块挂载:autodream / 检索工具 / 观测 / 写入门lib/memory/—— 记忆层的纯函数与文件操作;lib/autodream/—— 自动做梦引擎lib/shared/—— 跨层零依赖的小判据:文件名规则 / 本地时间戳 / 两个体积上限(只许一份,test/duplication-test.mjs会红)- 界面侧:
client/*.js按屏分片(05-shared.js放跨屏小基元与类型词表),npm run build:client拼成lib/client.js - 依赖方向:
memory不认识autodream,recall只依赖memory,assembly不反向依赖组合根(test/structure-test.mjs会红)
参与开发
git clone https://github.com/gezi-wen/sage-mem
cd sage-mem
npm install
npm test # 全部断言(含三条守卫)- 断言脚本只依赖
node:内置模块,不引测试框架,各脚本手写ok()并以汇总行收尾。 - 三条守卫盯的是「测试本身站不站得住」:
suite-registry-test.mjs(有没有写了不跑的套件)、contract-binding-test.mjs(有没有说了不验的承诺)、doc-consistency-test.mjs(两份文档的定性是否逐行一致)。 - CI 在
ubuntu-latest上跑两遍(第二遍TZ=UTC)—— 区分大小写的卷能逮到 Windows 上看不见的缺陷。 - 改了用户可见行为时,请同时更新 契约 的对应行与 CHANGELOG;写不出断言的承诺只能标「尽力」。
问题与建议:开 Issue。小而明确的修复欢迎直接提 PR;改动面较大的先开 Issue 对齐方向,免得白做。
常见问题
记忆没被注入怎么办?
先确认记忆目录对不对(SAGE_MEM_DIR,默认 ~/.sage-mem/memory),再看文件有没有 frontmatter(坏掉的 frontmatter 会被宽容解析:字段回落默认,文件照样读得到)。面板里的「体检」页会报出索引悬空、漏索引、断链这类结构问题。
为什么换个说法就搜不到了?
检索是词面重合,不是语义的。给这条记忆加一行 aliases: [另一种说法] 即可。这是有意的取舍,不是待修的缺陷。
它会不会把我说的每句话都记下来? 不会。存不存由模型按规则判断:无实质内容的不存,靠读代码 / git 能推出来的不存。
我想看看它到底存了什么。 打开记忆目录,全是 Markdown。GUI 里的「记忆管理」页也能浏览、编辑、删除。
多个 DSH 实例共用同一个记忆目录安全吗? 不。写入串行只保证进程内,跨进程没有文件锁 —— 同时用两个实例写同一目录仍可能丢一次。这是已知边界。
能不用自动做梦吗? 能,它默认就是关闭的。它和归档是两件事:归档是确定性规则(按闲置天数),不调模型、不花钱。
插件市场报「registry 上的最新版比已装还旧,更新会降级」?
那是下载地区镜像的 /latest 缓存滞后,不是包发错了:镜像的全量元数据(pnpm 读的那份)已经是新版,但 /<包>/latest 这个快捷入口还缓存着旧值。先等一两分钟重试;仍然不行就把插件市场的「下载地区」临时切到「全球」(直连 registry.npmjs.org)更新,完成后再切回。核对实际发布版本:npm view sage-mem dist-tags。
卸载
dsh plugin --profile web remove sage-mem或手动在 profile 的 package.json 里删掉 sage-mem 依赖、并从 dsh.profile.bundles 移除 "sage-mem";pnpm install 后重启 DSH。
记忆 Markdown 文件留在原目录,不受影响。
维护者
致谢
- @bjvgukv25842-cmyk —— 最早的 Web 记忆管理界面(记忆管理页的起点)。
- DeepSeek Harness —— 插件宿主与 Cordis 插件体系。
相关项目
- DeepSeek Harness — DSH 本体,一切皆插件
- awesome-dsh-plugin — DSH 插件生态清单
旧版
本仓库早期是 SQLite + worker 架构,已归档到 sqlite-worker 分支。文件式是继任实现。
License
Apache-2.0 · 见 LICENSE